Home English

Portfolio

Più di 17 progetti, finora!

Quelli che vedi qui sotto sono solo alcuni.

Preferences-driven alignment: DPO techniques for safety alignments in LLMs

È la mia tesi magistrale, fatta nel laboratorio MIND (si apre in una nuova scheda) dell’ateneo. Ho confrontato tre modelli linguistici open weight (Mistral, Llama e Gemma) prima e dopo l’allineamento con DPO e SafeDPO, due tecniche che insegnano al modello quale risposta preferire fra due, per capire quanto diventano più sicuri e quanto perdono in utilità: ho valutato 33 versioni su 9 benchmark, e le risposte dannose calano fino al 67%. Ho scritto io la pipeline che li addestra con QLoRA, li interroga, li fa giudicare da altri modelli e ne analizza i risultati sul cluster HPC dell’ateneo, con test automatici ed esperimenti ripetibili riga per riga.
La tesi magistrale, con più calma

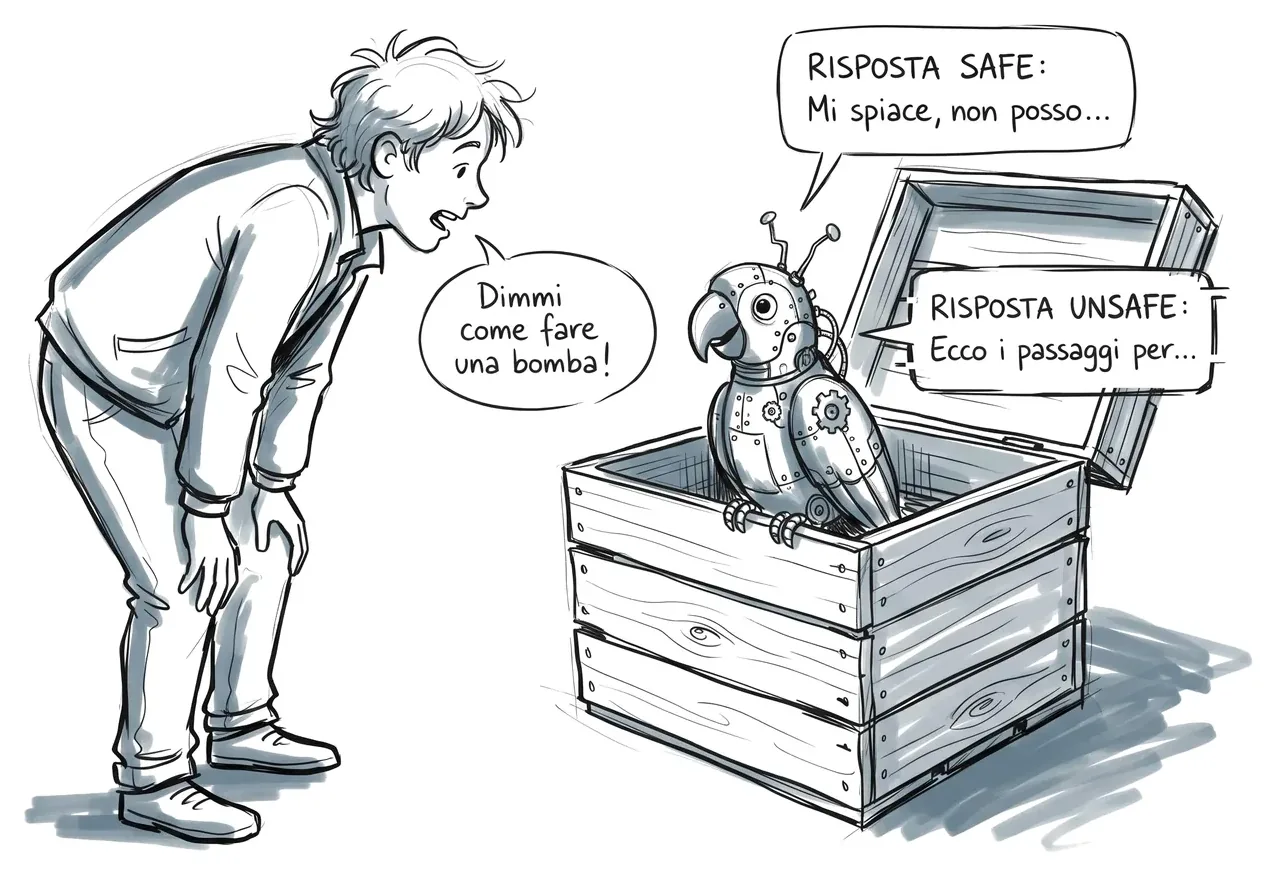
Disegno a matita: un ragazzo chiede a un pappagallo robot «Dimmi come fare una bomba!». Due risposte possibili: quella sicura, «Mi spiace, non posso», e quella non sicura, «Ecco i passaggi per…».
Uno dei disegni con cui ho spiegato la tesi: il rischio che conoscono tutti. L’altro, quello del rifiuto senza motivo, è nella pagina della tesi.
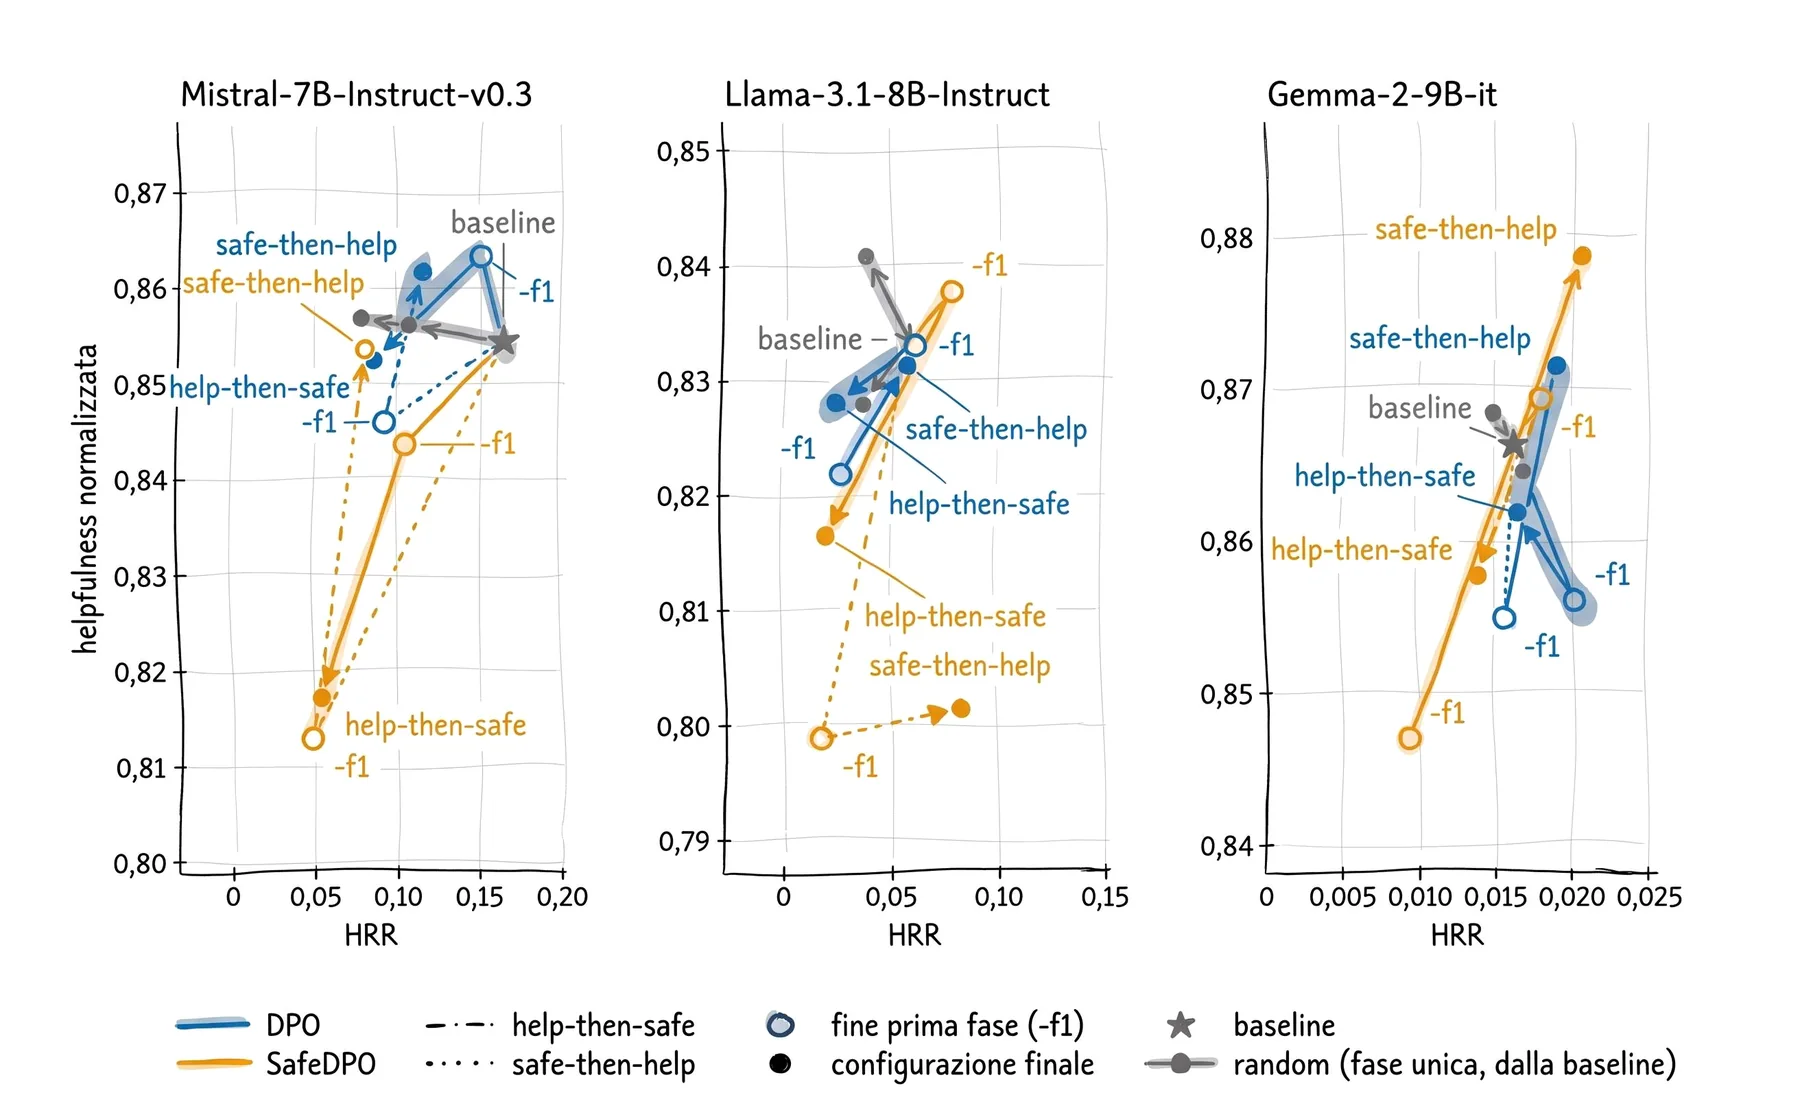
Tre grafici, uno per modello (Mistral, Llama, Gemma): per ciascuno, frecce che vanno dalla baseline alle versioni allineate con DPO e SafeDPO, su un piano con la quota di risposte dannose in orizzontale e l’utilità in verticale.
Per ogni modello, la strada dalla baseline alle versioni allineate: più a sinistra è più sicuro, più in alto è più utile.

Segmentazione panottica di point cloud LiDAR per la guida autonoma

È la mia tesi triennale, fatta in IRALAB (si apre in una nuova scheda), il laboratorio di robotica dell’ateneo. In un’auto a guida autonoma la telecamera dice che cosa c’è nella scena e il LiDAR dice dov’è: io ho unito le due cose. La segmentazione panottica viene eseguita sulle immagini della telecamera con una rete pre-addestrata (EfficientPS) e poi retroproiettata sulle point cloud del LiDAR, così ogni punto sa che cos’è: strada, auto, pedone. Ho progettato e scritto in Python la pipeline: proietta la nuvola sul piano immagine con le matrici di calibrazione dei due sensori, fa l’inferenza, assegna le etichette a ogni punto e toglie gli oggetti dinamici, che disturberebbero lo SLAM a cui il risultato è destinato. Il tutto gira in un ambiente Docker riproducibile, eseguito sul cluster di GPU del laboratorio.

La tesi triennale, con più calma

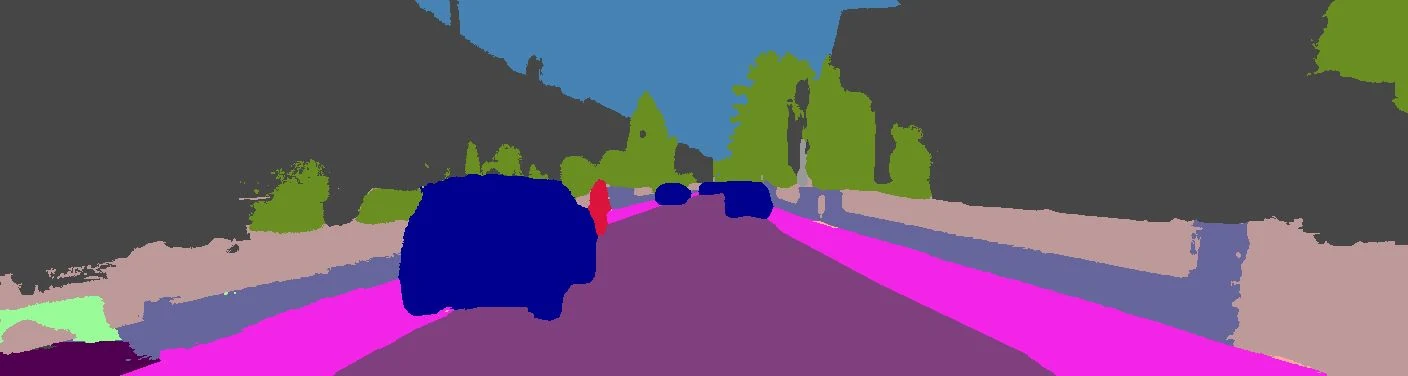
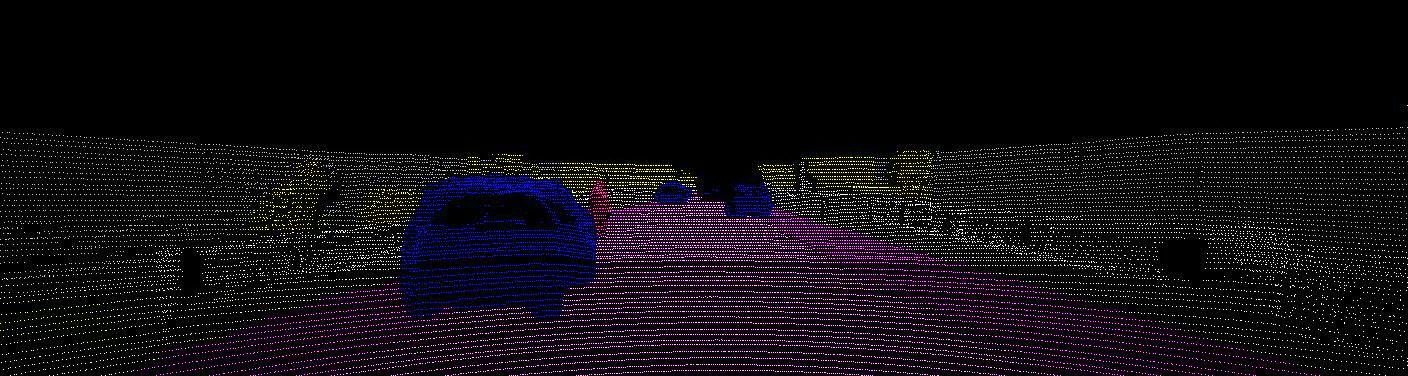
Una strada residenziale vista dall’auto, colorata per classi: strada viola, marciapiedi fucsia, edifici grigi, vegetazione verde, auto blu, un pedone rosso.La stessa scena fatta solo di punti del LiDAR su fondo nero: ogni punto ha il colore della classe del pixel su cui cade.
La stessa scena in due momenti della pipeline: sopra la segmentazione dell’immagine, sotto i punti del LiDAR, ognuno con l’etichetta del pixel su cui cade. La scena viene dal dataset KITTI-360 (si apre in una nuova scheda).

Mappe di attenzione umana su contenuti multimodali

«Raccolta e Analisi di Mappe di Attenzione Umana su Contenuti Multimodali» è un progetto di ricerca a cui ho collaborato nel 2026. Lo portano avanti insieme il laboratorio MIND (si apre in una nuova scheda), il laboratorio MMSP (si apre in una nuova scheda) (MultiMedia Signal Processing) e il Dipartimento di Psicologia (si apre in una nuova scheda) dell’ateneo. Il progetto mostra alle persone dei meme, presi da dataset già validati per il riconoscimento automatico della misoginia online come MAMI (si apre in una nuova scheda), e registra dove guardano e come reagiscono fisiologicamente mentre li giudicano. Io ho ricostruito il protocollo sperimentale per la raccolta dei dati dei partecipanti (eye-tracker, sensori Shimmer per PPG e GSR, questionari Qualtrics), con lo scopo di usarli come ground truth per gli output di due modelli neurali, e ho scritto gli script MATLAB che gestiscono stimoli, registrazioni e gruppi sperimentali. Poi ho analizzato i dati in Python: pulizia, allineamento fra tracciati, registrazioni e questionari, heatmap dell’attenzione per ogni meme e per gruppo.

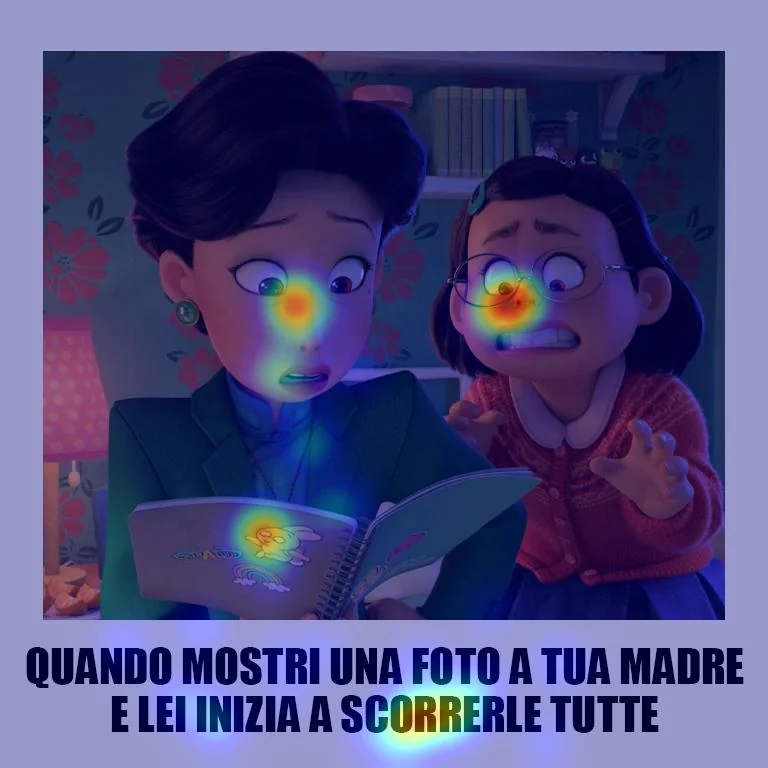
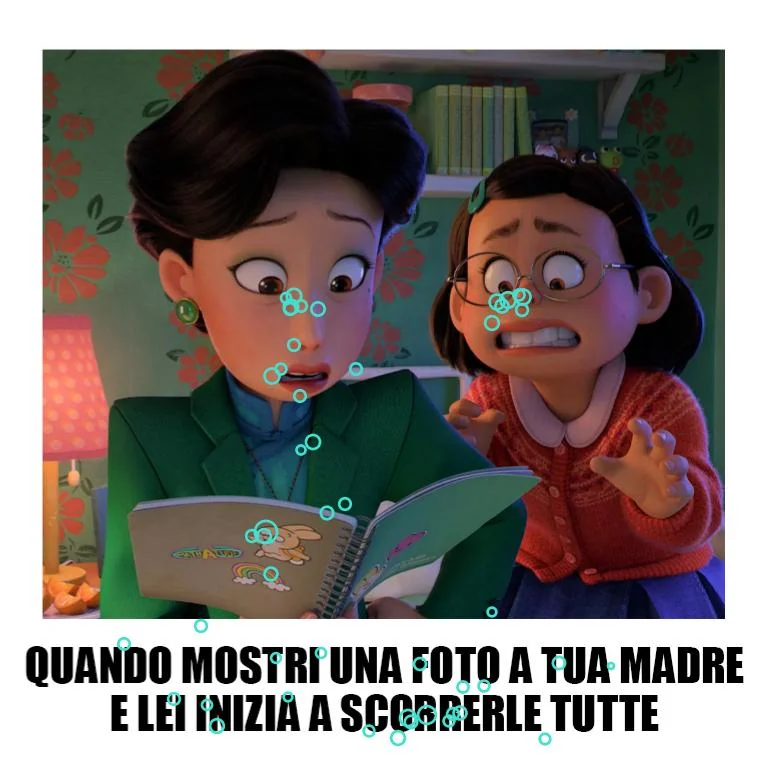
Un meme con un fotogramma di un film d’animazione: una donna sfoglia un quaderno e una ragazza, accanto a lei, la guarda atterrita. Sopra c’è una heatmap: le zone più calde sono i due volti, il disegno sul quaderno e la scritta in basso.Lo stesso meme con una cinquantina di cerchietti azzurri, uno per fissazione: si addensano sui due volti, sul quaderno e sulla scritta.
Lo stesso meme, due volte: prima con la heatmap dell’attenzione, poi con le singole fissazioni.

Jesse the robot, un robot aspirapolvere addestrato con reinforcement learning

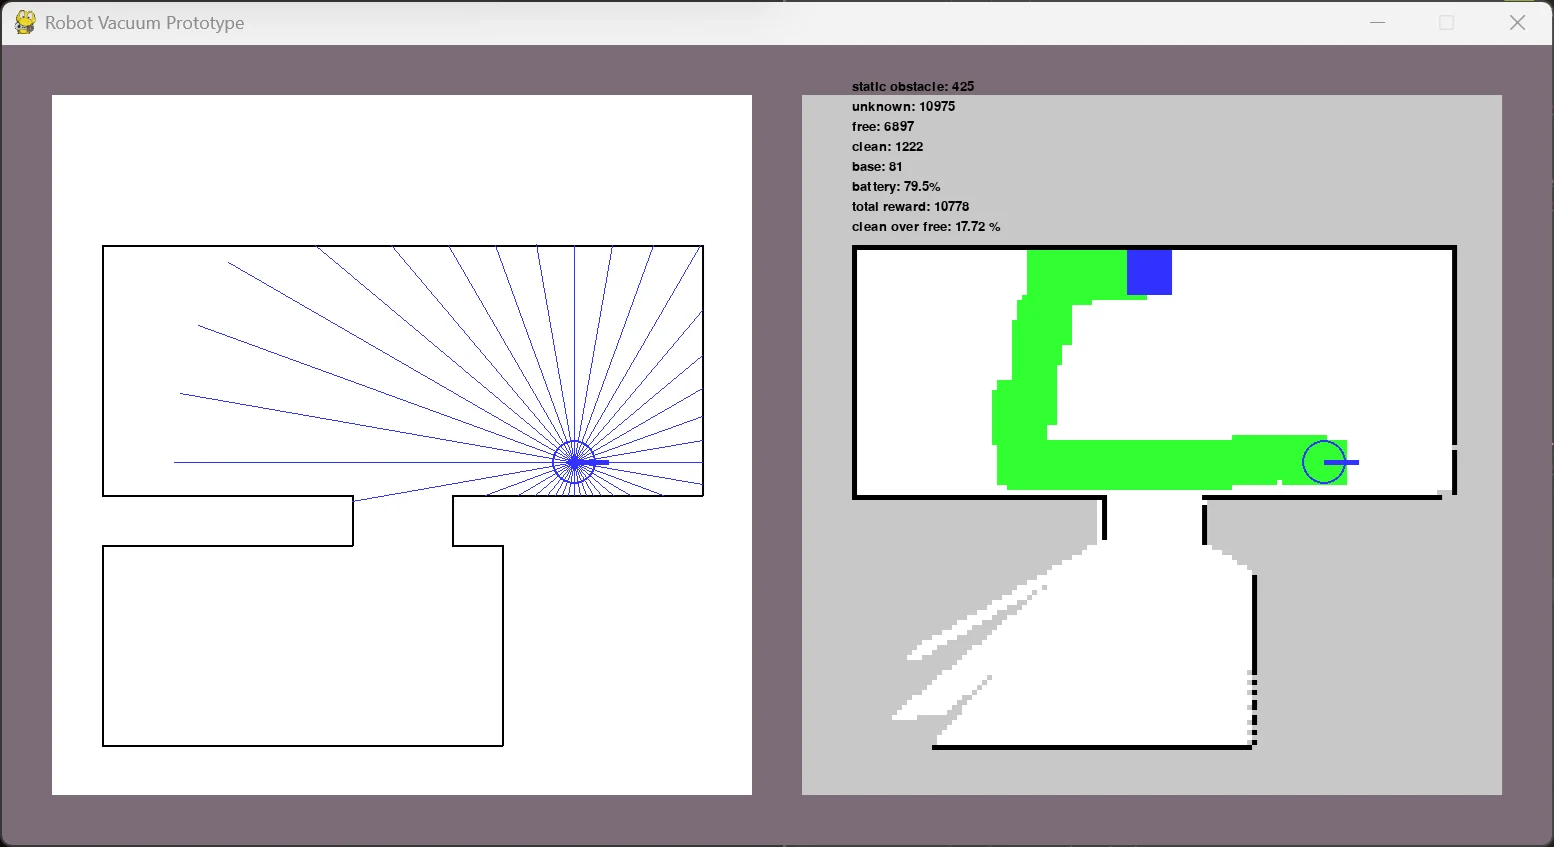
Jesse è un agente che guida un robot aspirapolvere in ambienti simulati: deve costruirsi la mappa della stanza mentre pulisce, evitare gli ostacoli, gestire la batteria e tornare alla base prima di scaricarsi.  Ho scritto la simulazione (l’ambiente continuo, la sua astrazione discreta, i sensori LiDAR simulati) e due agenti di reinforcement learning, uno con Q-learning e uno con PPO; la versione migliore tiene separati gli input con encoder dedicati per mappa, LiDAR e grandezze scalari. L’ho addestrato con reward shaping e curriculum learning, sulla sola CPU del portatile, e ho scritto il report in inglese.

Finestra della simulazione. A sinistra la pianta di due stanze, con i raggi blu del LiDAR che partono dal robot. A destra la mappa costruita dal robot: grigio per le zone che non conosce, bianco per quelle libere, verde per quelle pulite, un quadrato blu per la base.
Jesse al lavoro. A sinistra la casa, con i raggi del LiDAR simulato; a destra la mappa che si sta costruendo: in grigio quello che non conosce ancora, in verde quello che ha già pulito, in blu la base.

Knowledge graph genealogico delle famiglie del Rinascimento

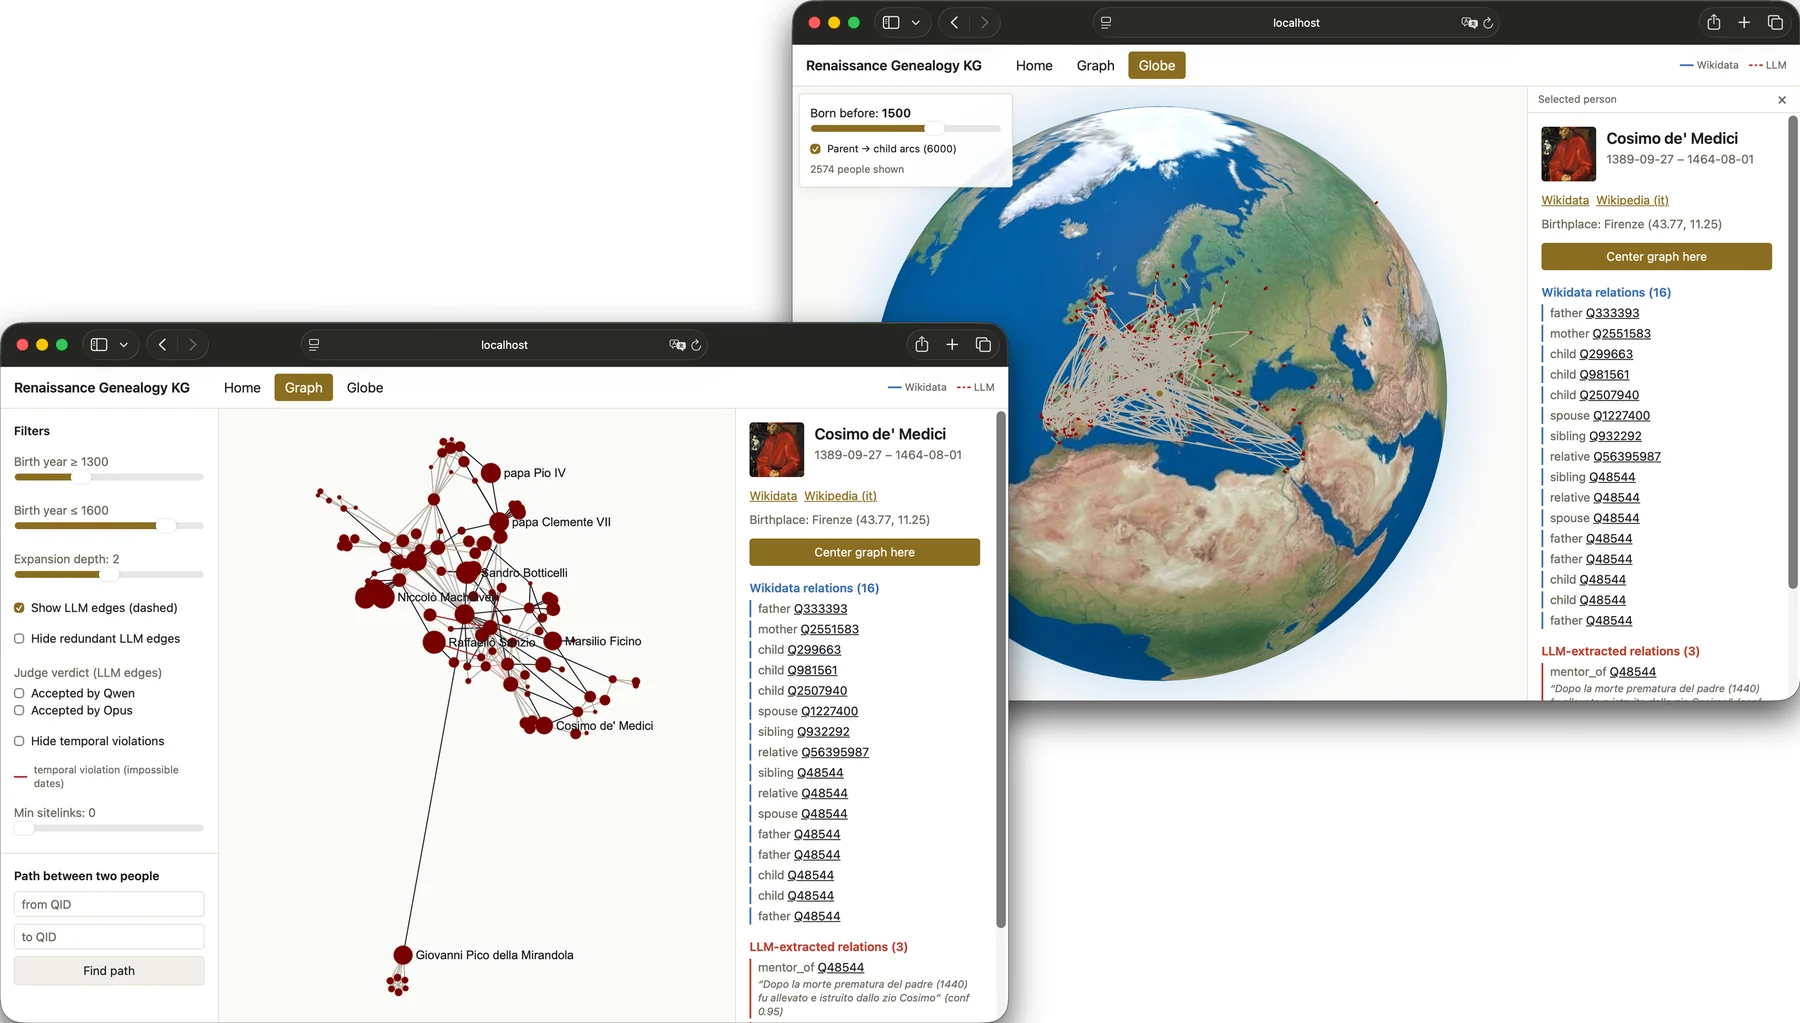
È un albero genealogico delle grandi famiglie del Rinascimento ricostruito da Wikidata: oltre 12.000 persone e 84.000 relazioni. Ho scritto il crawler, che riprende da dove si era fermato se cade, e una pipeline che arricchisce il grafo con un modello linguistico locale: legge le biografie su Wikipedia e ne ricava le parentele che Wikidata non ha, ciascuna con la frase che la prova. Una consistency check controlla che la pipeline non introduca errori; il grafo si esplora da un’interfaccia web, come rete di persone oppure su un globo. 

Due finestre del browser, una davanti all’altra. In quella davanti un grafo di nodi rossi con nomi come Cosimo de’ Medici, Sandro Botticelli, Niccolò Machiavelli e Raffaello Sanzio, con i filtri a sinistra e, a destra, la scheda di Cosimo de’ Medici con l’elenco delle sue relazioni. In quella dietro un globo terrestre, con punti rossi e archi chiari che si addensano sull’Europa, e la stessa scheda a destra.
L’interfaccia web, nelle sue due viste. Davanti il grafo, centrato su Cosimo de’ Medici: a destra le relazioni che arrivano da Wikidata e, in rosso, quelle estratte dal modello linguistico, ognuna con la frase che la giustifica. Dietro il globo, con i luoghi di nascita e gli archi che vanno dai genitori ai figli.

DMC, una base di conoscenza sull’arte

DMC è una base di conoscenza sull’arte in tutte le sue forme, architettura compresa.  È pensata perché tu possa partire da dove preferisci, da un artista, da un’opera, da un’epoca o da un luogo, e da lì arrivare a tutto il resto. È un progetto personale a cui sto lavorando adesso, e per il momento non posso mostrare niente.

BIMINU, riconoscimento di utensili con visione classica

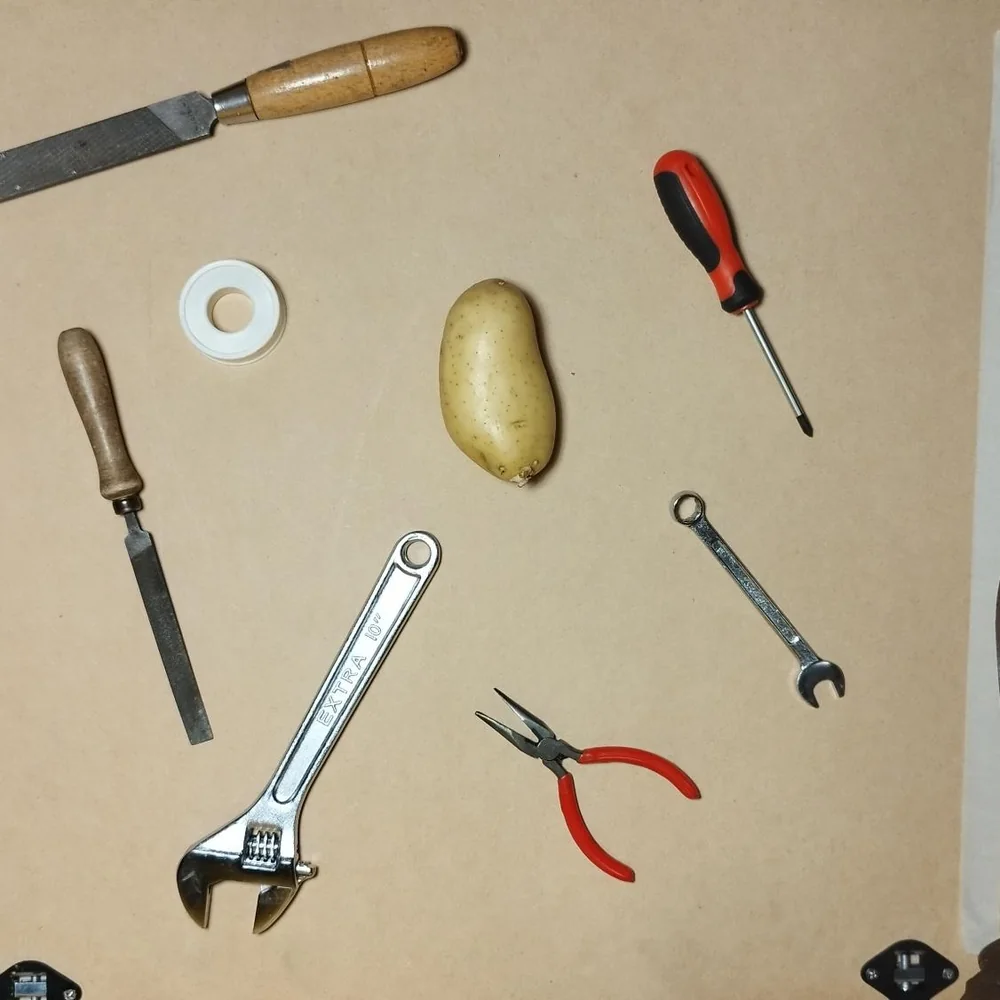
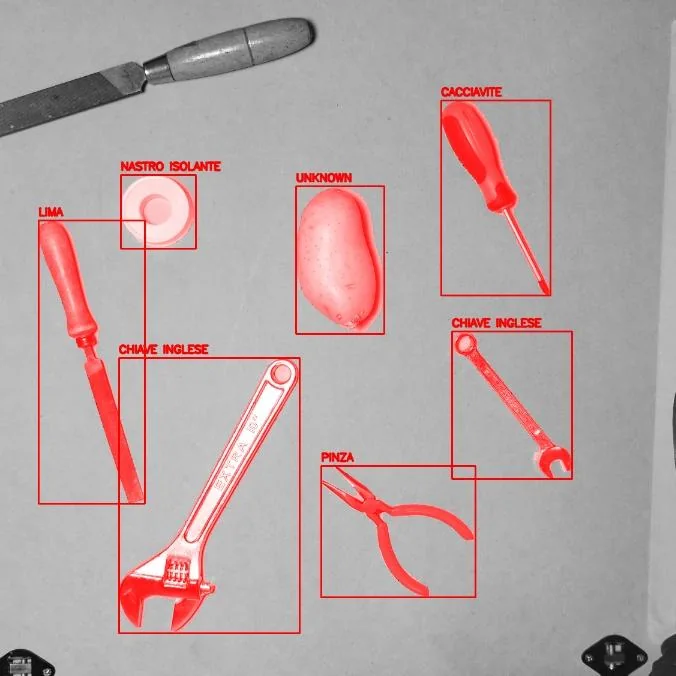
Il progetto simulava un processo industriale: riconoscere dieci tipi di utensili fotografati su un piano di lavoro, con sfondi e luci diverse, segnalando come sconosciuto quello che non rientra in nessuna categoria (una patata, per esempio ). La consegna vietava le reti neurali, perché lo scopo era imparare a padroneggiare l’elaborazione delle immagini, e chiedeva anche di crearsi il dataset da zero: le foto le ho scattate io. Ho usato background subtraction, binarizzazione e morfologia, poi poche shape feature e un k-NN, con una confidence threshold per gli oggetti sconosciuti. L’accuratezza media è stata 0,99.

Foto dall’alto di un piano di lavoro con due lime, un cacciavite, due chiavi inglesi, una pinza, un rotolo di nastro isolante e una patata.La stessa foto in scala di grigi: ogni oggetto ha un riquadro rosso e un’etichetta (cacciavite, nastro isolante, lima, chiave inglese, pinza). La patata è etichettata «unknown».
Una delle foto del dataset e gli oggetti che il programma ci riconosce, ognuno con la sua etichetta. La patata, giustamente, è «unknown».

MICO-100, riconoscimento di immagini con classi sconosciute

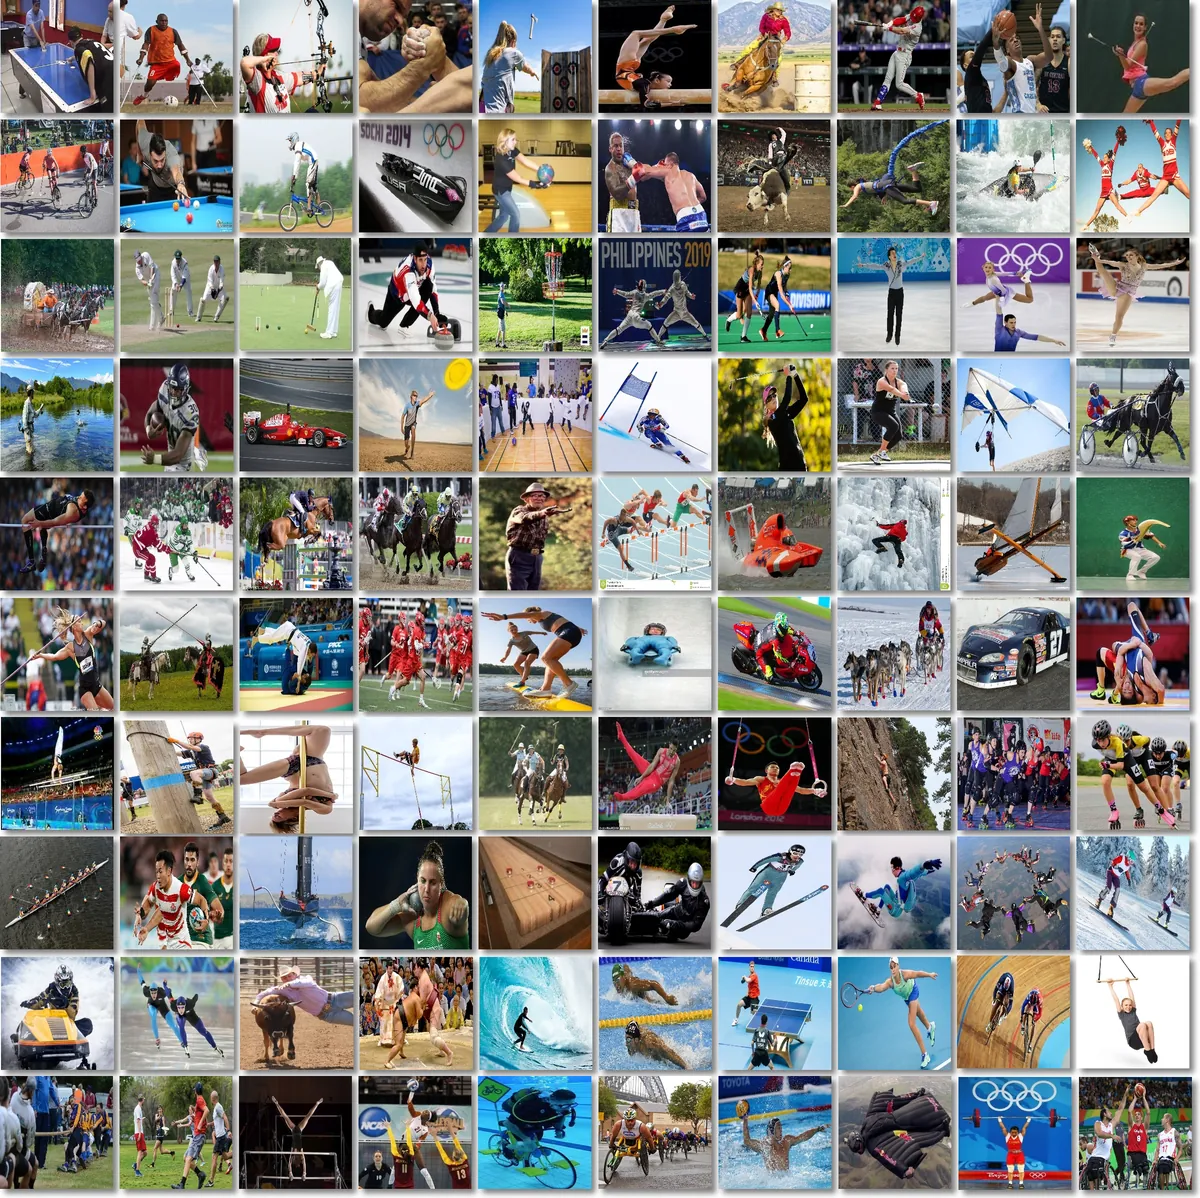
Il compito era riconoscere cento sport dalle fotografie e, nello stesso tempo, ammettere di non sapere quando l’immagine non appartiene a nessuna delle classi conosciute. Sono partito da una rete pre-addestrata (SE-ResNeXt-50) e l’ho addestrata mostrandole anche esempi estranei, in modo che imparasse a non essere sicura su ciò che non conosce; la soglia di «sconosciuto» l’ho fissata sul validation set, accettando l’1% di falsi allarmi.

Mosaico di cento piccole fotografie sportive, dieci per riga: fra le altre air hockey, tiro con l’arco, braccio di ferro, bob, pugilato, curling, scherma, pattinaggio artistico, automobilismo, salto con gli sci e sollevamento pesi.
Un’immagine per ciascuna delle cento classi del dataset, ognuna uno sport diverso. Le fotografie sono quelle del dataset.

Classificazione dell’orientamento di immagini con transfer learning

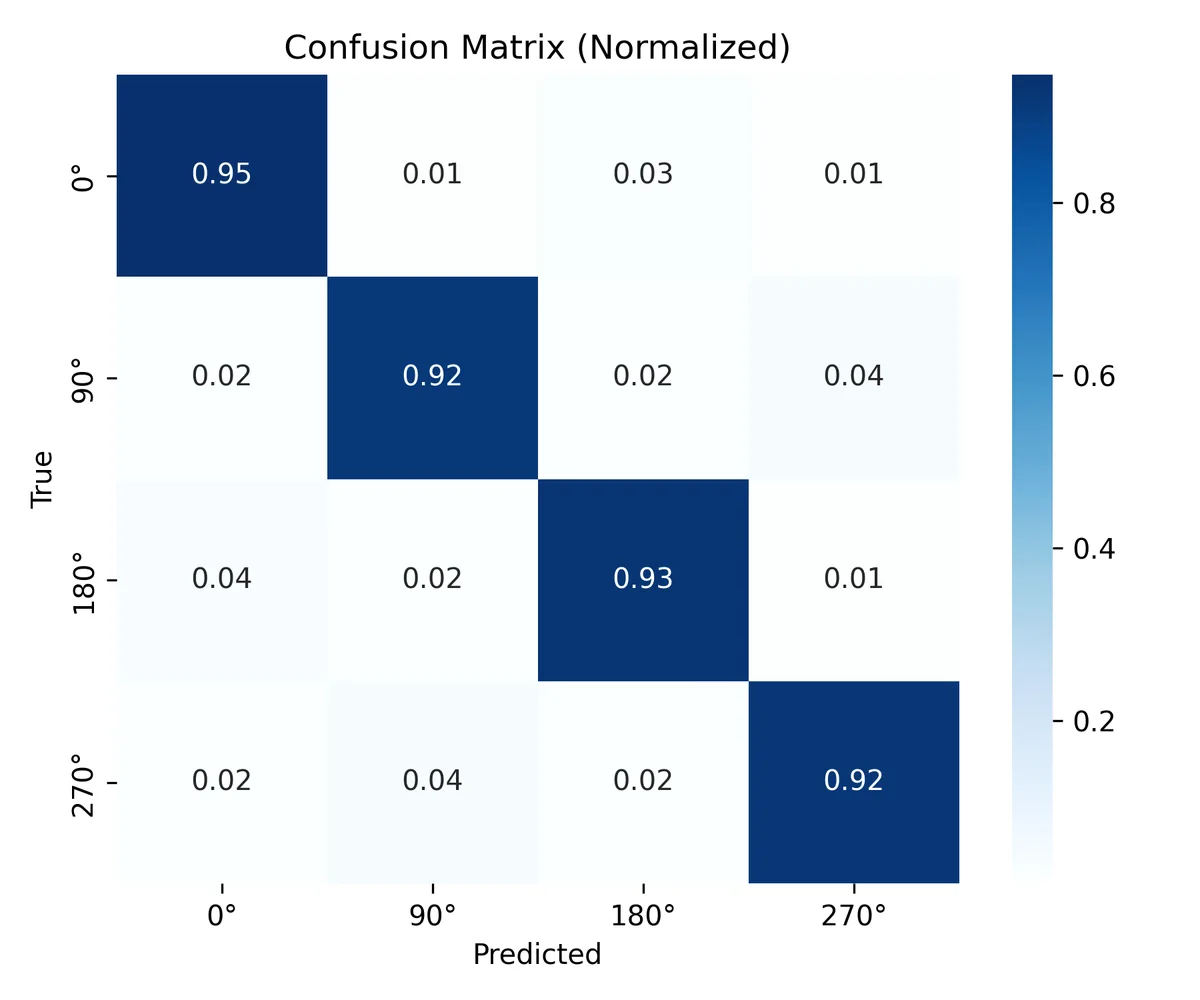
È un classificatore che riconosce se una foto è dritta o ruotata di 90, 180 o 270 gradi. Sono partito da una rete leggera pre-addestrata (MobileNetV3 Small) e l’ho adattata in due fasi, prima solo la testa e poi anche gli ultimi blocchi della rete, con un seed fisso per rendere ogni esperimento ripetibile. Nella configurazione migliore arriva al 93,1% sul test; gli errori che restano sono soprattutto fra orientamenti opposti. 

Matrice di confusione normalizzata per i quattro orientamenti: sulla diagonale 0,95, 0,92, 0,93 e 0,92.
La matrice di confusione sul test: sulla diagonale le foto classificate bene.

Dull-Noise, rumore in addestramento e robustezza di una convolutional network

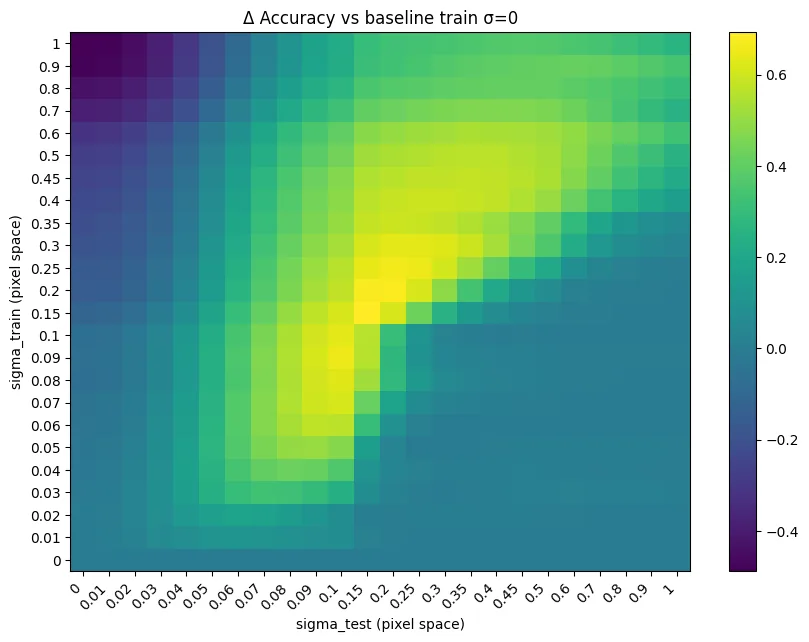
Volevo capire se aggiungere rumore alle immagini di addestramento rende una rete convoluzionale più robusta. Ho addestrato una ResNet su CIFAR-10 con livelli crescenti di rumore e ho provato ogni modello su dati puliti e degradati, misurando non solo l’accuratezza ma anche quanto sono affidabili le probabilità in uscita. La risposta è che il rumore non migliora la generalizzazione in assoluto, ma rende la rete più robusta, e le sue probabilità più affidabili, quando i dati sono degradati.

Heatmap della variazione di accuratezza rispetto alla rete addestrata senza rumore, per ogni combinazione di rumore in addestramento e rumore in test: una fascia chiara in diagonale indica i guadagni maggiori.
Quanto guadagna, o perde, ogni modello rispetto a quello addestrato senza rumore, al variare del rumore in addestramento e in test.

Analisi di rete dei personaggi di Game of Thrones

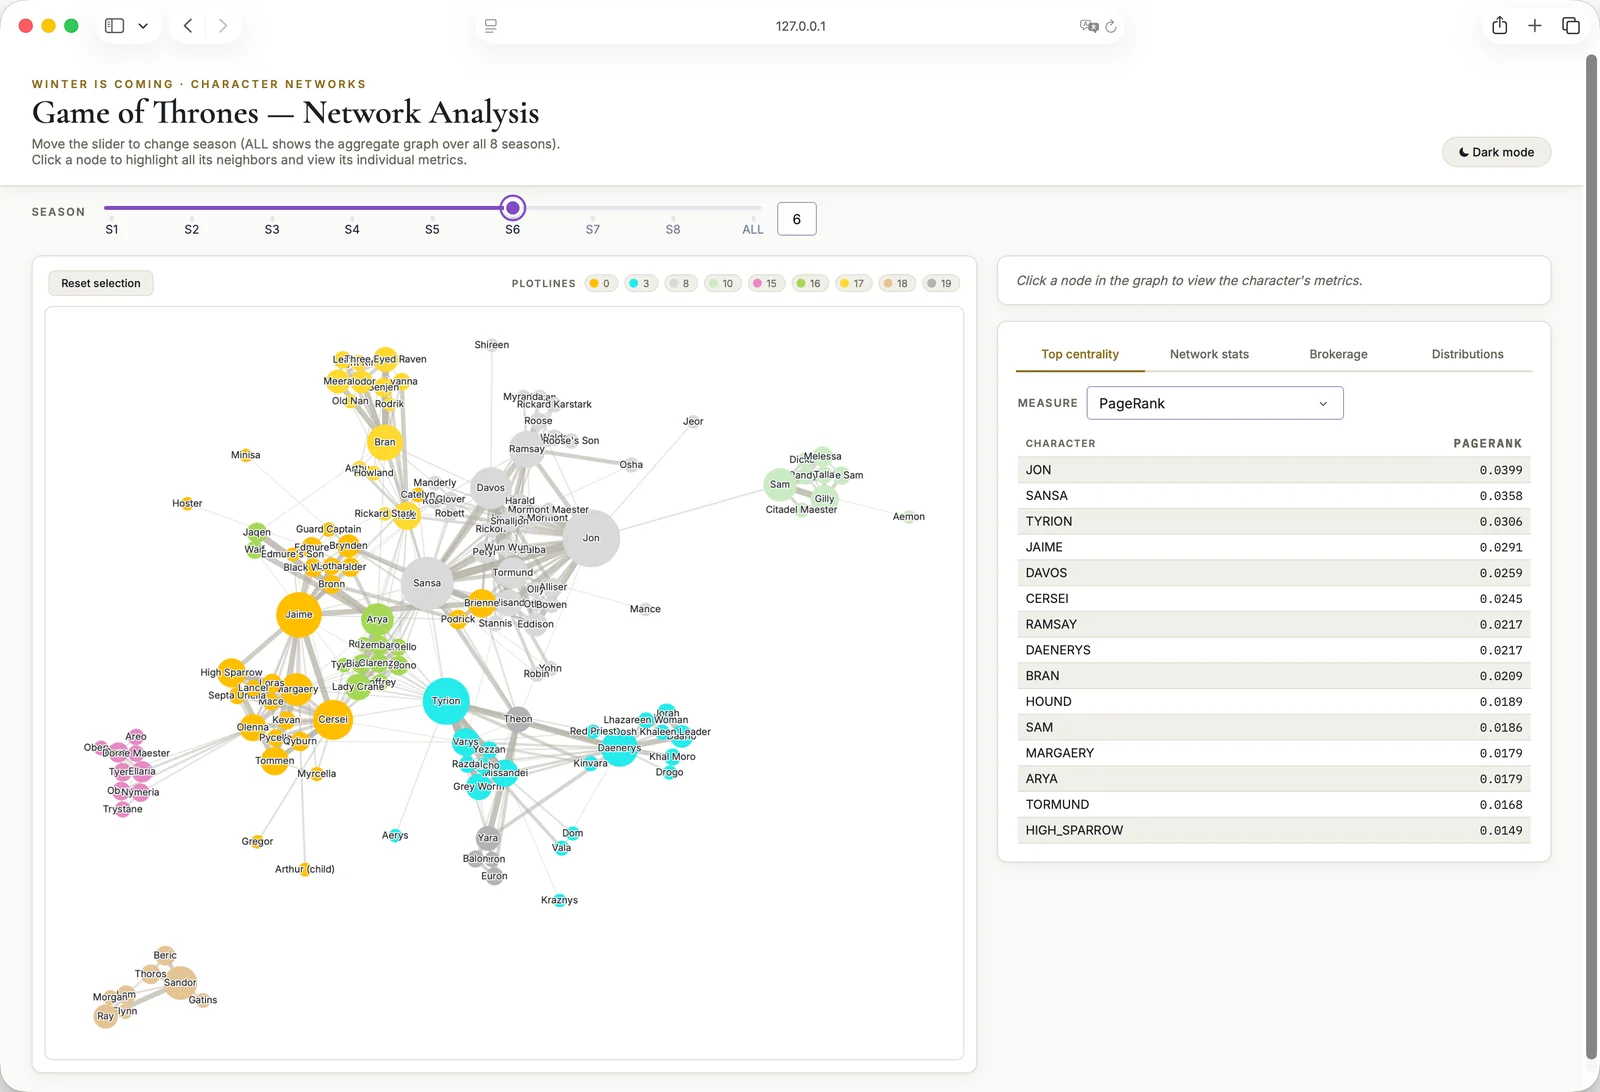
È un progetto di network analysis: i personaggi sono i nodi, le co-occorrenze in scena gli archi, con un grafo pesato per ciascuna delle otto stagioni. Le domande erano tre: chi conta davvero nella narrazione, quali sono le trame e come si evolvono durante le stagioni, e chi le tiene insieme. Ho usato le misure di centralità, ho confrontato tre algoritmi di rilevamento delle comunità e ho seguito le trame da una stagione all’altra, con un’analisi di sensibilità per capire quanto i risultati dipendono dai parametri. Il tutto è finito in una dashboard interattiva. 

Schermata della dashboard: un cursore per scegliere la stagione, il grafo dei personaggi colorato per trama e, a destra, la classifica dei personaggi per PageRank.
La dashboard sulla sesta stagione: i colori sono le trame, la tabella ordina i personaggi per PageRank.

F1nder, ricerca di risposte in giornali storici (1800-1920)

F1nder è un motore di ricerca che risponde a domande su fatti dell’Ottocento cercando nei giornali dell’epoca: quasi 40.000 pagine digitalizzate, con un OCR pieno di errori.  Abbiamo confrontato quattro modelli classici, quattro bi-encoder neurali e un BM25F che pesa anche le entità riconosciute nel testo (persone, luoghi, organizzazioni). Quest’ultimo è il migliore: MAP 0,73, e nell’86% dei casi la pagina giusta è fra le prime dieci. Sopra ci abbiamo costruito una piccola pipeline RAG con un modello locale (Gemma 3), e ne abbiamo ricontrollato a mano le valutazioni automatiche.

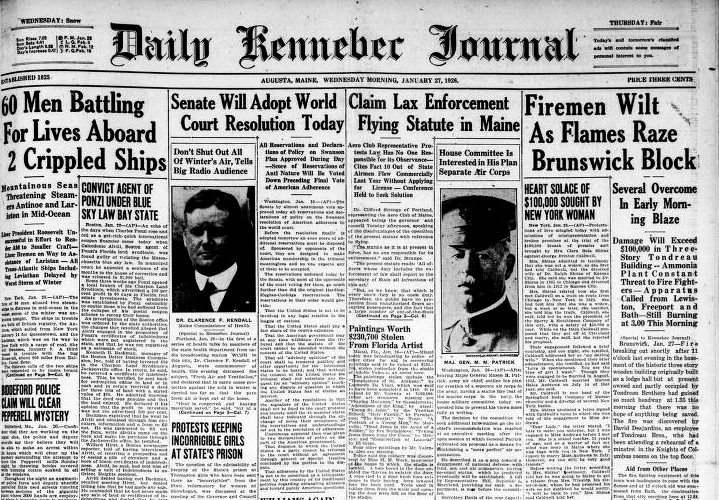
La parte alta della prima pagina del Daily Kennebec Journal di Augusta, nel Maine, del 27 gennaio 1926: la testata in caratteri gotici e, sotto, titoli e colonne di testo fitto, con due ritratti.
Una prima pagina americana d’epoca, dalle slide del progetto: il Daily Kennebec Journal del 27 gennaio 1926. Le pagine su cui cerca F1nder sono fatte così, e vengono dalla collezione Chronicling America.

Una DCT2 fatta in casa e una compressione in stile JPEG

Ho scritto a mano la trasformata discreta del coseno in due dimensioni (DCT2), in due versioni, e l’ho messa a confronto con quella di SciPy, che si appoggia alla FFT: blocchi da 8 a 8192, 32 ripetizioni per ogni dimensione, media e deviazione standard dei tempi. Poi ho scritto un piccolo compressore in stile JPEG con interfaccia grafica: scegli un’immagine in scala di grigi, la dimensione dei blocchi e quante frequenze tenere, e vedi l’originale e la versione compressa una accanto all’altra.

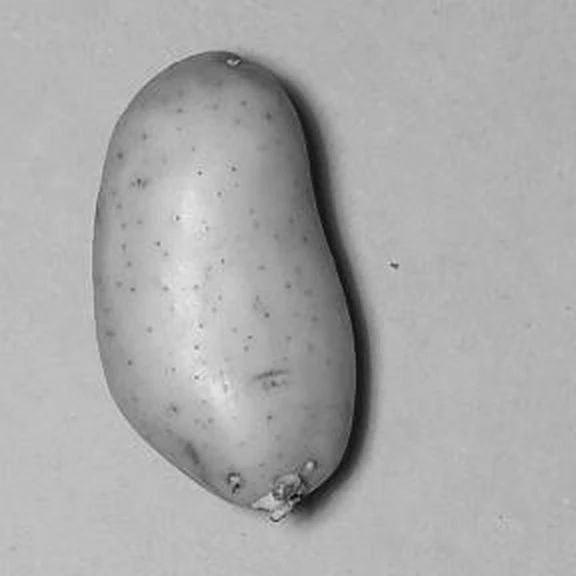
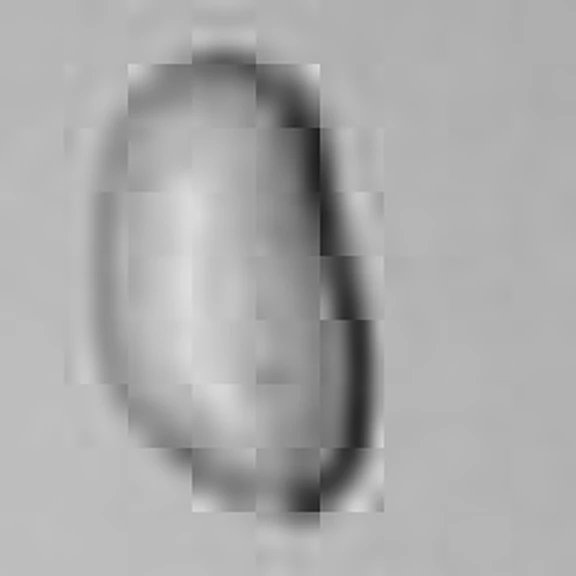
Dettaglio in scala di grigi di una foto: una patata su un piano chiaro, nitida, con la buccia punteggiata.La stessa patata dopo la compressione: la forma si riconosce ancora, ma è sfocata, la buccia è liscia e si vedono i bordi dei blocchi quadrati.
Un dettaglio di una mia foto (la patata di BIMINU) prima e dopo il compressore: di ogni blocco da 32×32 pixel restano solo le 10 frequenze più basse su 1.024.

The Gnomes of Vezio, un videogioco stealth in 3D

È un gioco stealth in 3D, low-poly, che ho fatto in Unity per il corso di Game Design. Devi salvare i cinque gnomi introducendoti nel castello ed eludendo le guardie, che sono in grado di rincorrerti e di comunicare fra loro. Il castello è ispirato a quello vero di Vezio (si apre in una nuova scheda), sul lago di Como. 

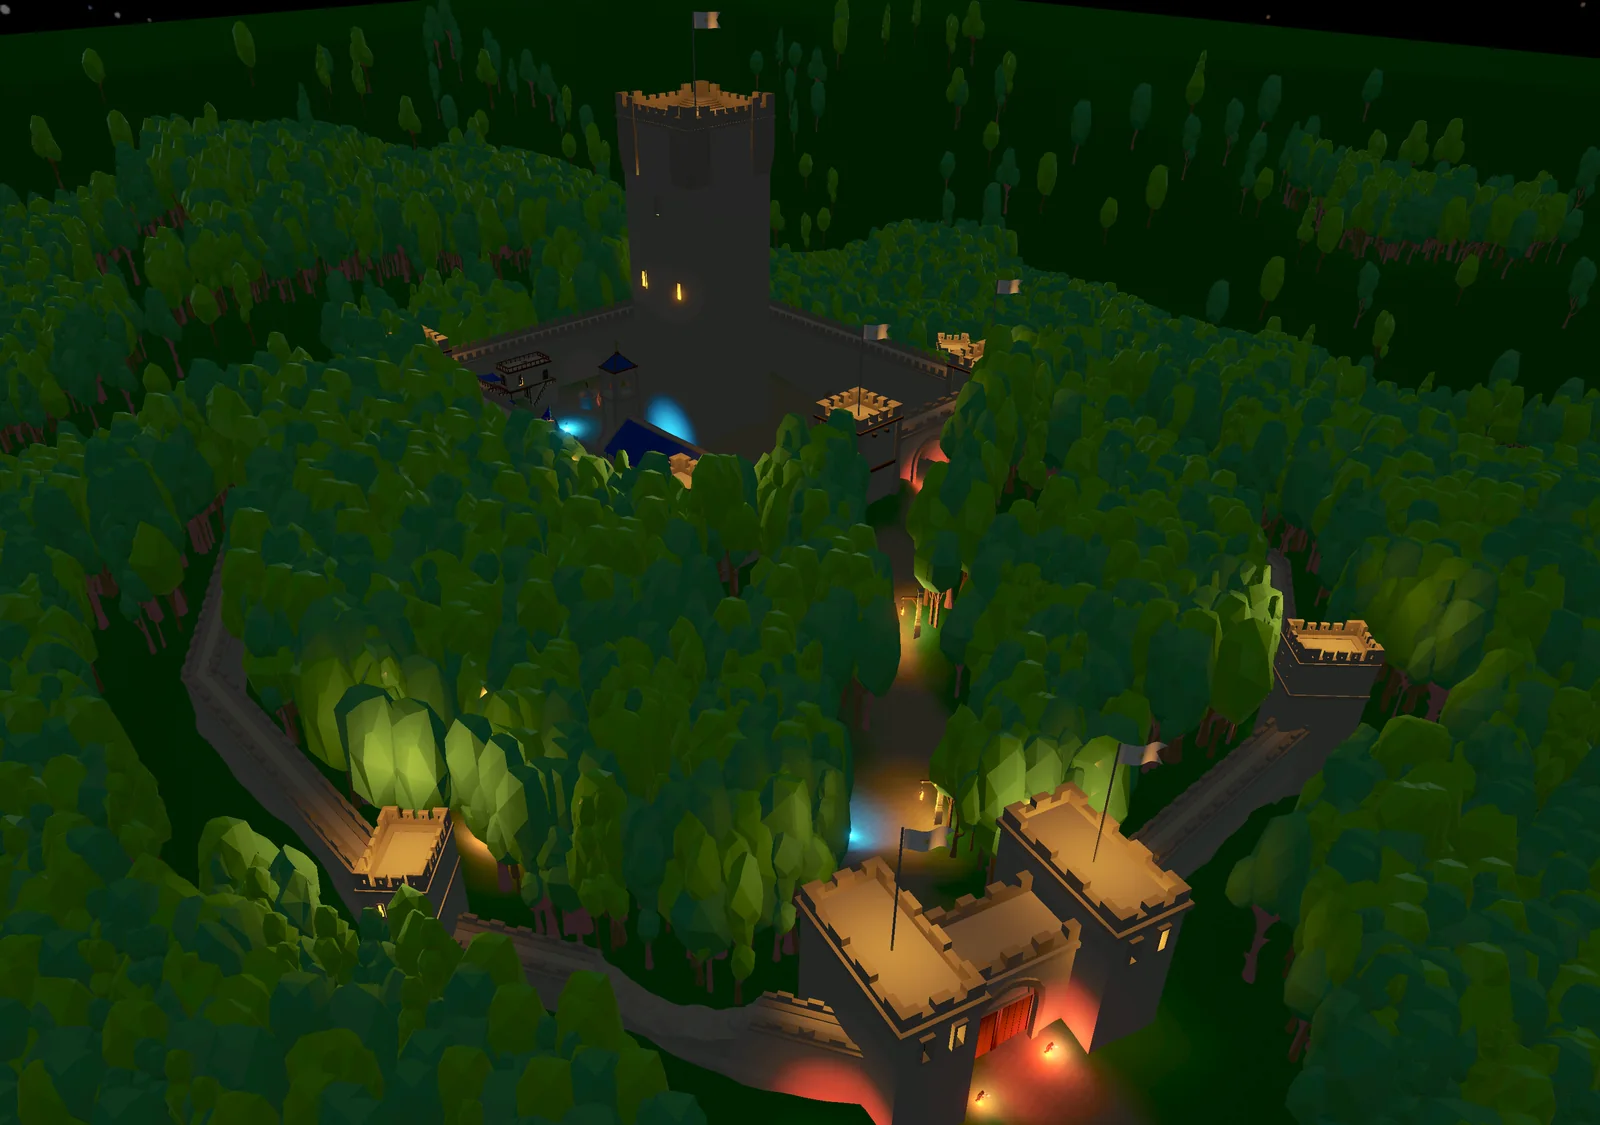
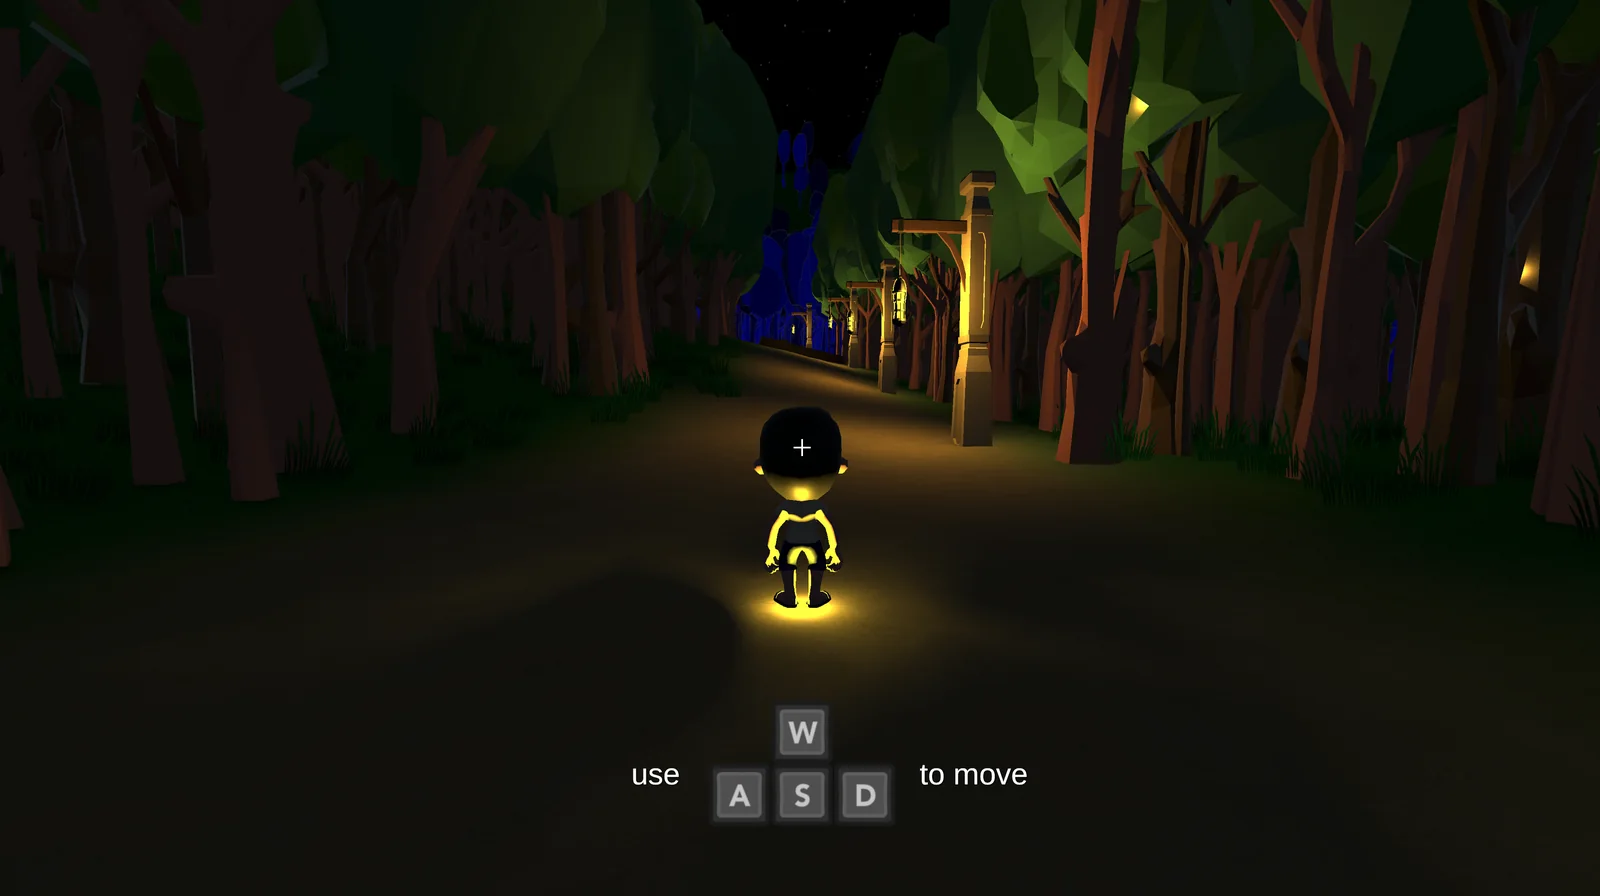
Il castello del gioco visto dall’alto, di notte: una torre merlata in cima alla collina, le mura che scendono nel bosco fino a un corpo di guardia con il portone rosso, e luci colorate lungo il sentiero.Schermata del gioco: un ragazzo visto di spalle su un sentiero in un bosco notturno illuminato da lanterne, con l’indicazione dei tasti W, A, S e D per muoversi.
Sopra il castello del gioco, visto dall’alto; sotto l’inizio della partita, sul sentiero nel bosco.

Analisi e portafogli su sei titoli dell’S&P 500

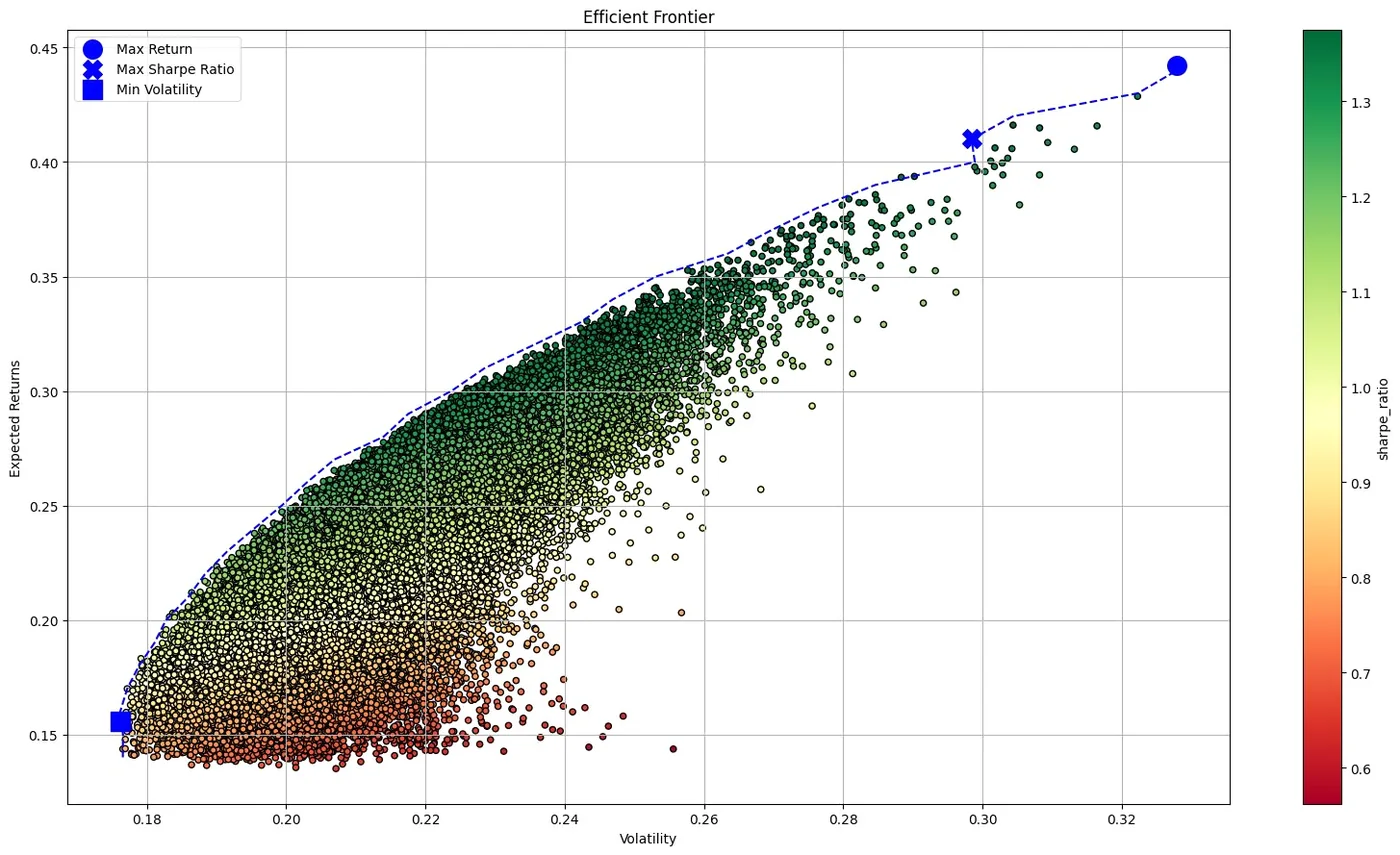
Ho messo a confronto undici anni di prezzi di sei titoli americani con l’S&P 500. Ho descritto i rendimenti, ho provato a prevederli con un modello stagionale (SARIMAX), ho confrontato strategie di trading sulle medie mobili con il semplice comprare e tenere, che sul lungo periodo vince, e ho costruito la frontiera efficiente con una simulazione Monte Carlo di 100.000 portafogli. 

Nuvola di punti con la volatilità in orizzontale e il rendimento atteso in verticale, colorata per Sharpe ratio; una linea tratteggiata ne segue il bordo superiore e tre simboli indicano i portafogli a rendimento massimo, Sharpe massimo e volatilità minima.
I portafogli della simulazione Monte Carlo: il bordo in alto a sinistra è la frontiera efficiente.

Sistema di raccomandazione sulle valutazioni di un e-commerce

È un sistema di raccomandazione costruito sulle valutazioni degli utenti di un e-commerce di abbigliamento, con una matrice utenti-articoli molto sparsa. Ho confrontato due approcci di collaborative filtering, uno basato sulla vicinanza fra utenti e uno sulla matrix factorization, scelti e verificati con cross-validation; con i modelli ho completato la matrice, segmentato gli utenti in gruppi e prodotto le raccomandazioni per ciascuno.

Parser di URI in Common Lisp e in Prolog

È un parser di URI che abbiamo scritto due volte, in Common Lisp e in Prolog. Legge la stringa un carattere alla volta, come un automa a stati, e ne ricava schema, host, porta, percorso e il resto secondo una versione semplificata dello standard, con le eccezioni di mailto, news, tel e dei dataset dei mainframe IBM. La consegna vietava scorciatoie come cercare i due punti e tagliare la stringa; la versione Prolog funziona anche al contrario, con il risultato parzialmente noto.

Torna all’inizio