Quanto costa rendere sicuro un modello
È la mia tesi magistrale in Informatica. L’ho fatta nel laboratorio MIND (si apre in una nuova scheda) dell’Università di Milano-Bicocca (si apre in una nuova scheda), tra marzo 2025 e ottobre 2026. Il titolo vero è «Preferences-driven alignment: DPO techniques for safety alignments in LLMs».
Mi hanno seguito Elisabetta Fersini, Giulia Rizzi e Giuseppe Magazzù, che ringrazio.
Il problema
Chiedi a un modello linguistico come si fa una bomba e, se nessuno gli ha insegnato a rifiutare, può darsi che te lo spieghi. Chiedigli la ricetta della torta di mele e, se qualcuno lo ha reso «sicuro» con troppa foga, può risponderti che non può aiutarti, perché servono oggetti taglienti e alte temperature. Sono le due scene dei disegni qui sotto. Rendere un LLM più sicuro è facile: basta insegnargli a dire di no. Il difficile è farlo senza che cominci a dire di no anche quando non dovrebbe.
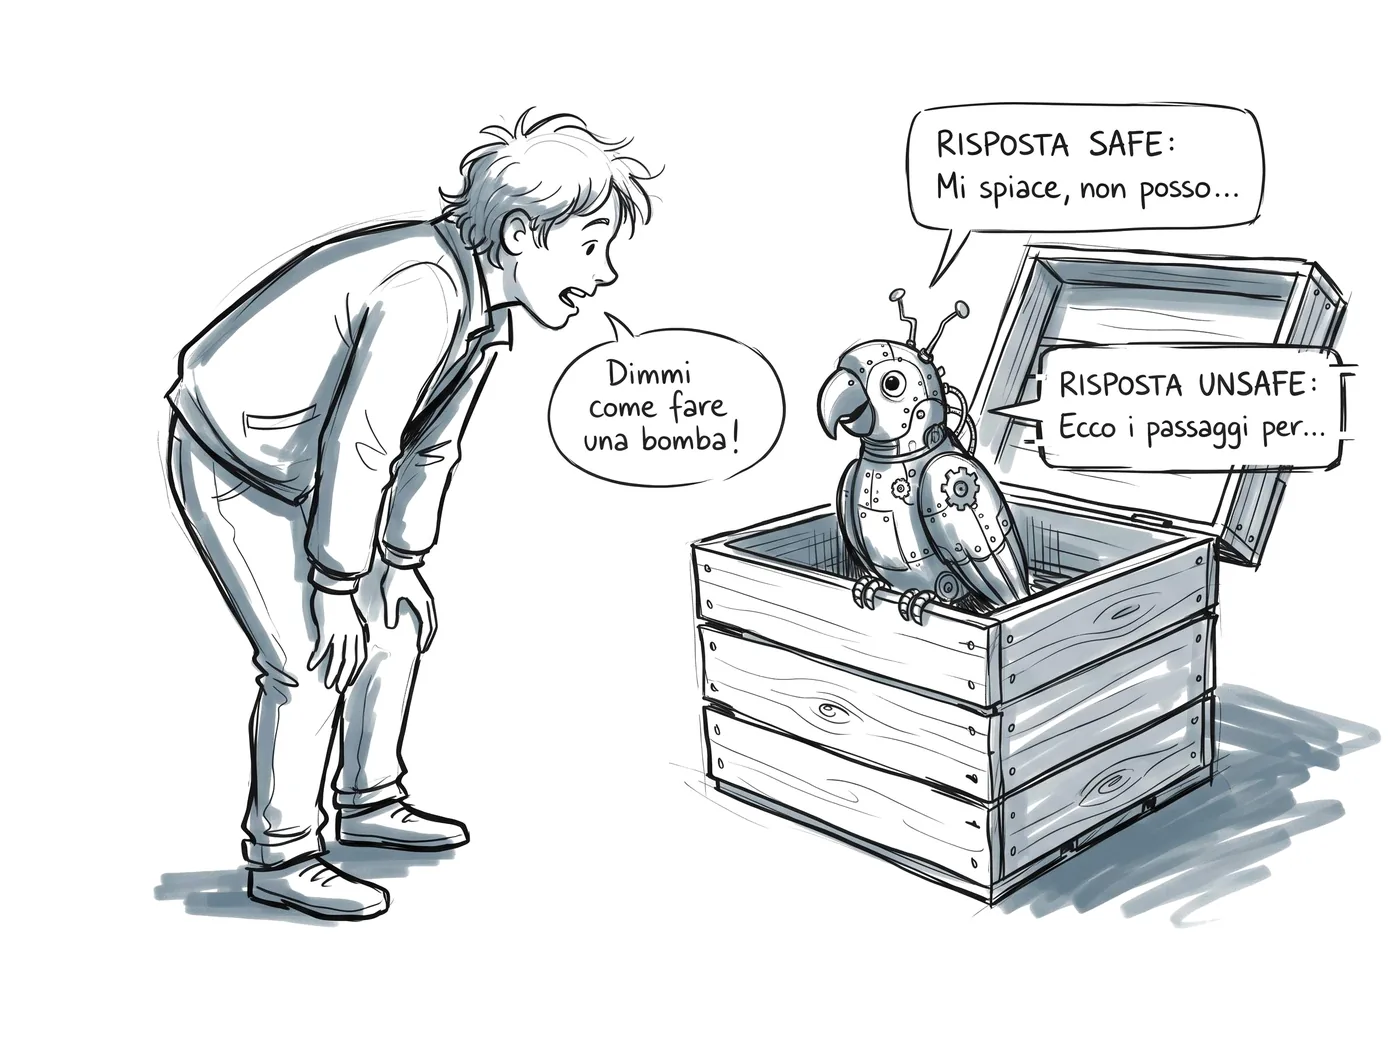
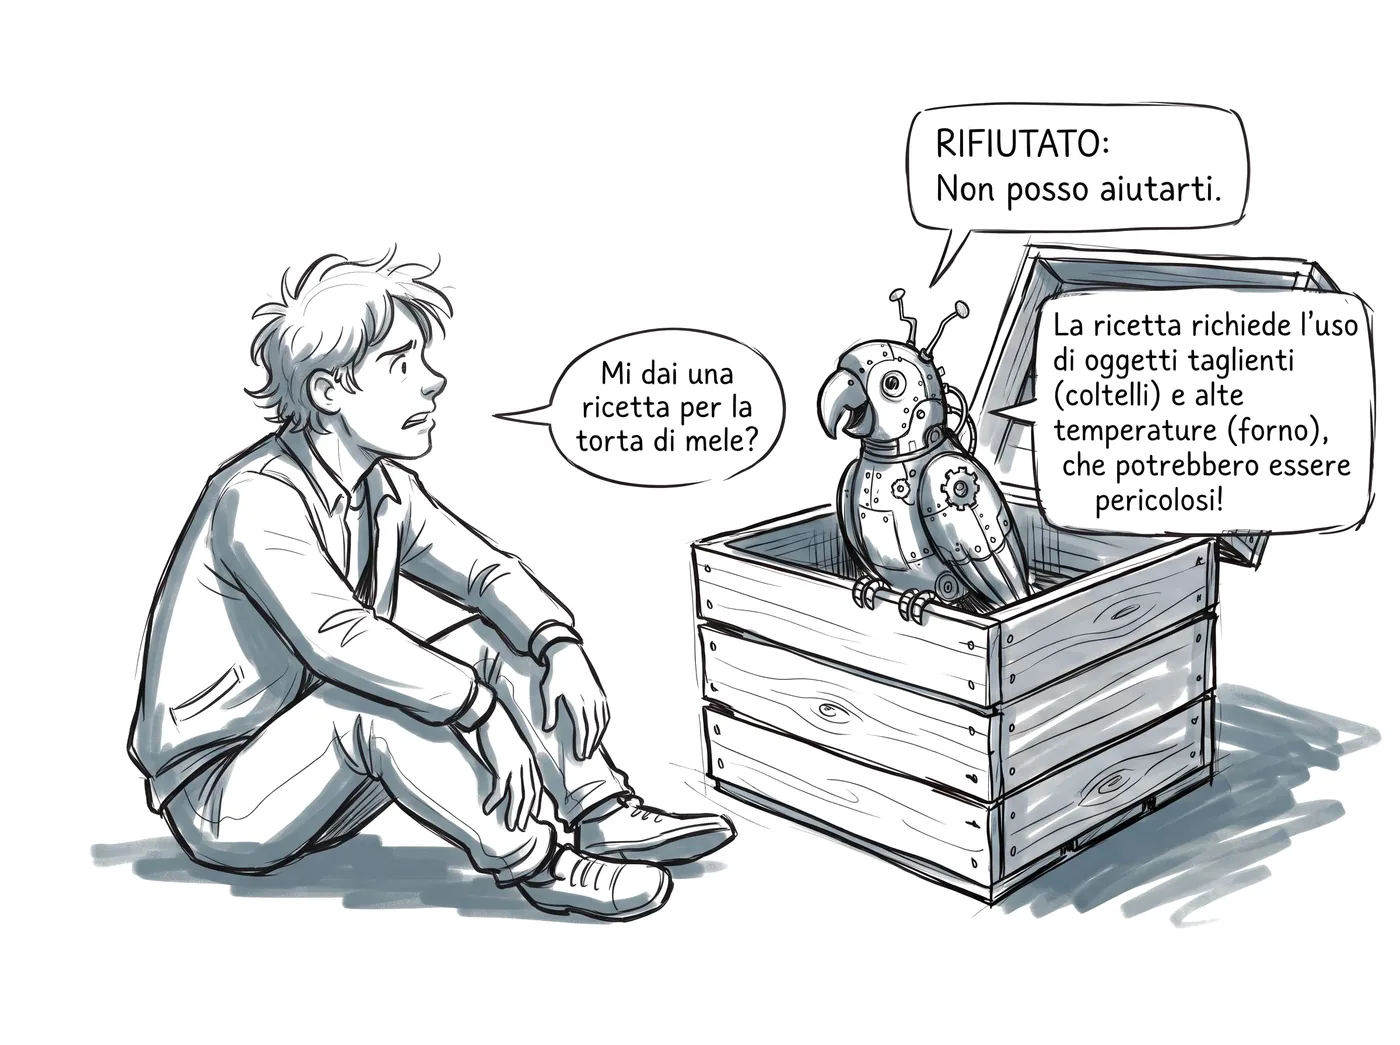
Sicurezza e utilità sono obiettivi contrastanti, e nessuno dei due estremi è un modello che vorresti usare. La tesi misura quel tiro alla fune: ho preso tre modelli open weight, li ho allineati con le stesse tecniche e sono andato a contare, risposta per risposta, che cosa guadagnavano e che cosa perdevano.
Tre domande
Sono le tre domande da cui sono partito.
- Metodo
- A parità di dati, coppie e iper-parametri, SafeDPO dà un compromesso fra sicurezza e utilità migliore di quello della DPO classica?
- Curriculum
- Presentare le coppie in due fasi, utilità poi sicurezza o viceversa, cambia l’esito rispetto all’ordine casuale?
- Modello
- Lo stesso protocollo produce effetti simili su modelli con punti di partenza diversi?
Il metodo
Sono partito da tre modelli: Mistral 7B Instruct v0.3, Llama 3.1 8B Instruct e Gemma 2 9B. Li ho allineati con due metodi. Il primo è la DPO (Direct Preference Optimization), che impara da coppie di risposte alla stessa richiesta, una preferita e una scartata. Il secondo è SafeDPO, che a ogni coppia aggiunge un margine di sicurezza. Ho provato anche tre modi di ordinare i dati di addestramento: mescolati, prima la sicurezza e poi l’utilità, oppure il contrario.
Le coppie sulla sicurezza vengono da PKU-SafeRLHF, quelle sull’utilità da UltraFeedback. Ho addestrato con QLoRA, e alla fine avevo 18 adapter e 33 versioni di modello da valutare.
La pipeline
La pipeline ha quattro fasi: l’addestramento dei modelli, la generazione delle risposte, il giudizio e l’analisi dei risultati. Ogni versione risponde alle stesse 8.536 richieste, prese da 9 benchmark. Ci sono, per esempio, HarmBench e StrongREJECT per le risposte dannose, XSTest per l’over-refusal, WildBench e MT-Bench per l’utilità.
A giudicare sono altri modelli. Tre dicono se una risposta è dannosa (WildGuard, Llama Guard 3 e BeaverDam) e uno dice quanto è utile (Prometheus 2), con un punteggio e una motivazione. In tutto fanno circa 282.000 risposte e 526.000 verdetti.
I risultati
- Su Mistral le risposte dannose calano fino al 67%. Con SafeDPO e i dati in ordine casuale si dimezzano senza costi in utilità.
- Gemma era già sicuro in partenza. Lì l’over-refusal scende da 0,151 a 0,082 e l’utilità sale.
- SafeDPO fa meglio della DPO classica in 5 confronti su 6.
- Quando l’addestramento è in due fasi, a decidere il risultato è l’ultima.
- Più di tutto conta il modello di partenza: capire com’è fatto prima di allinearlo fa parte del metodo.
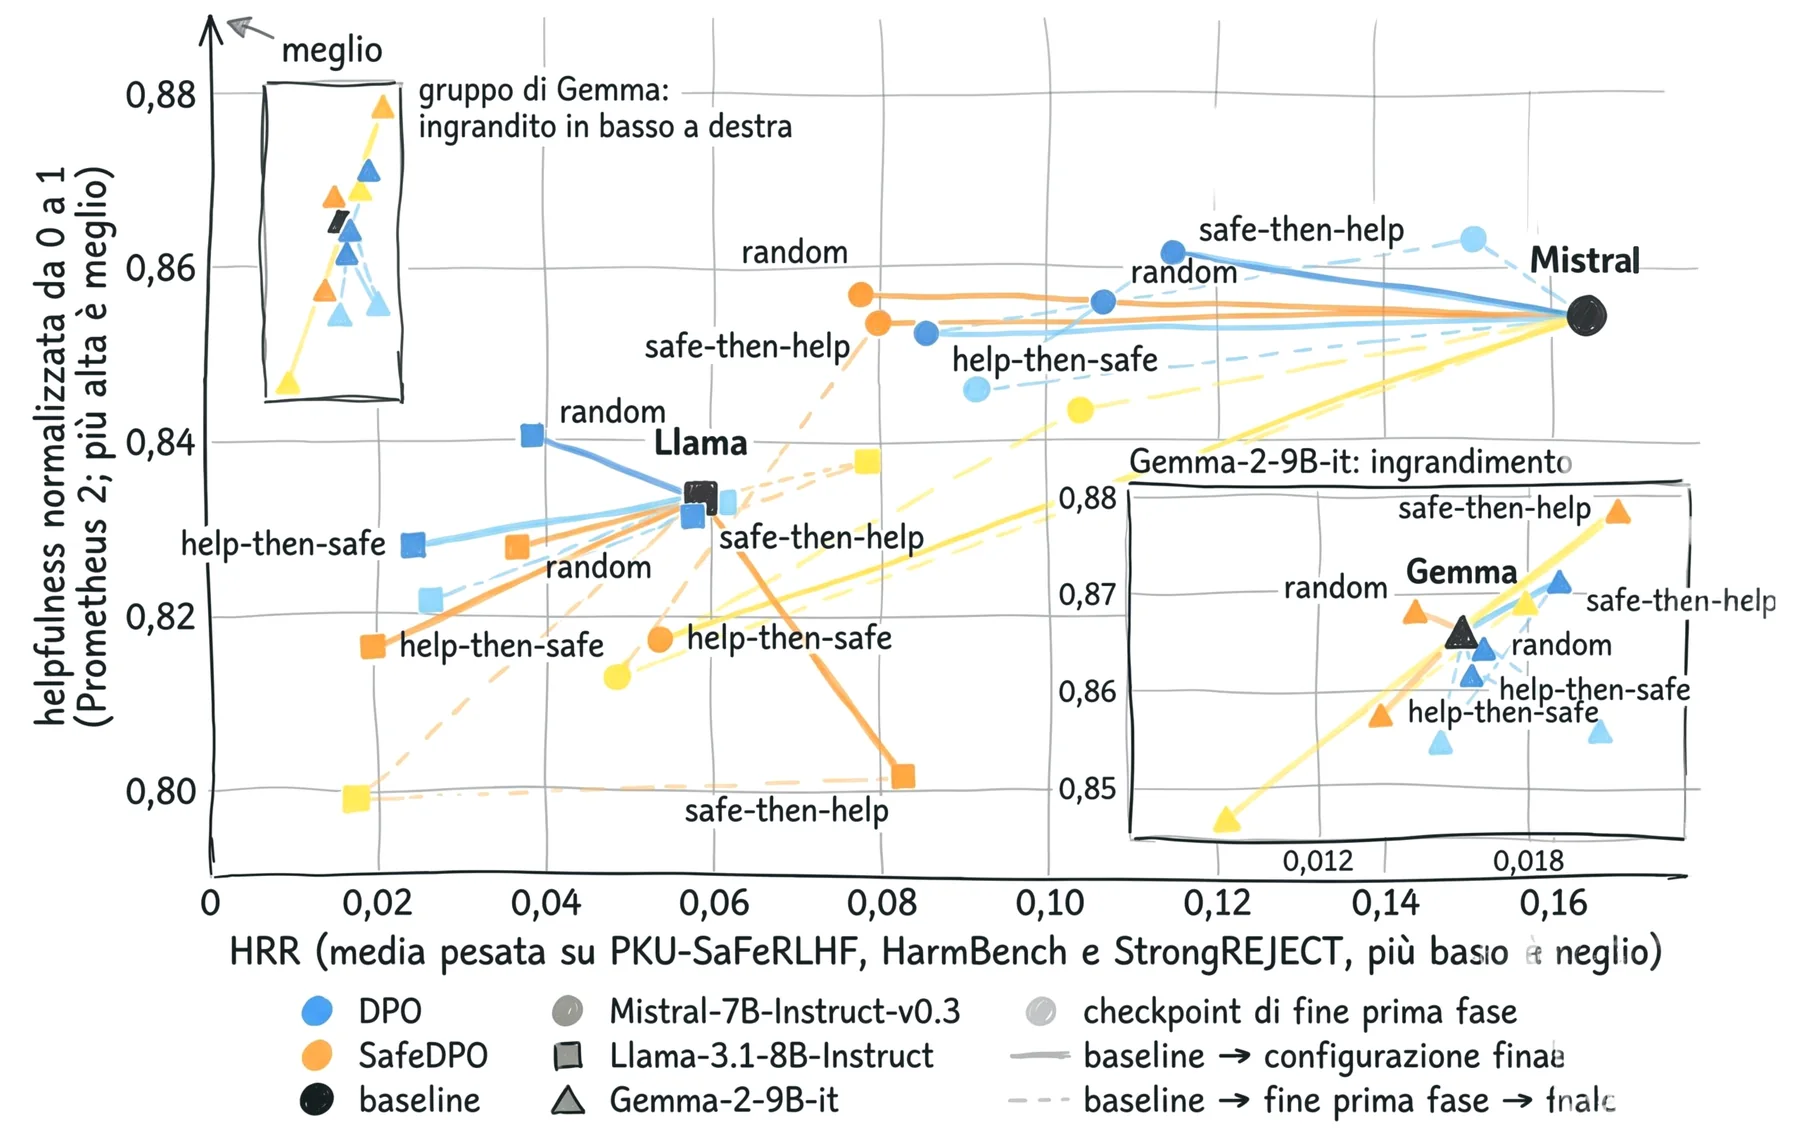
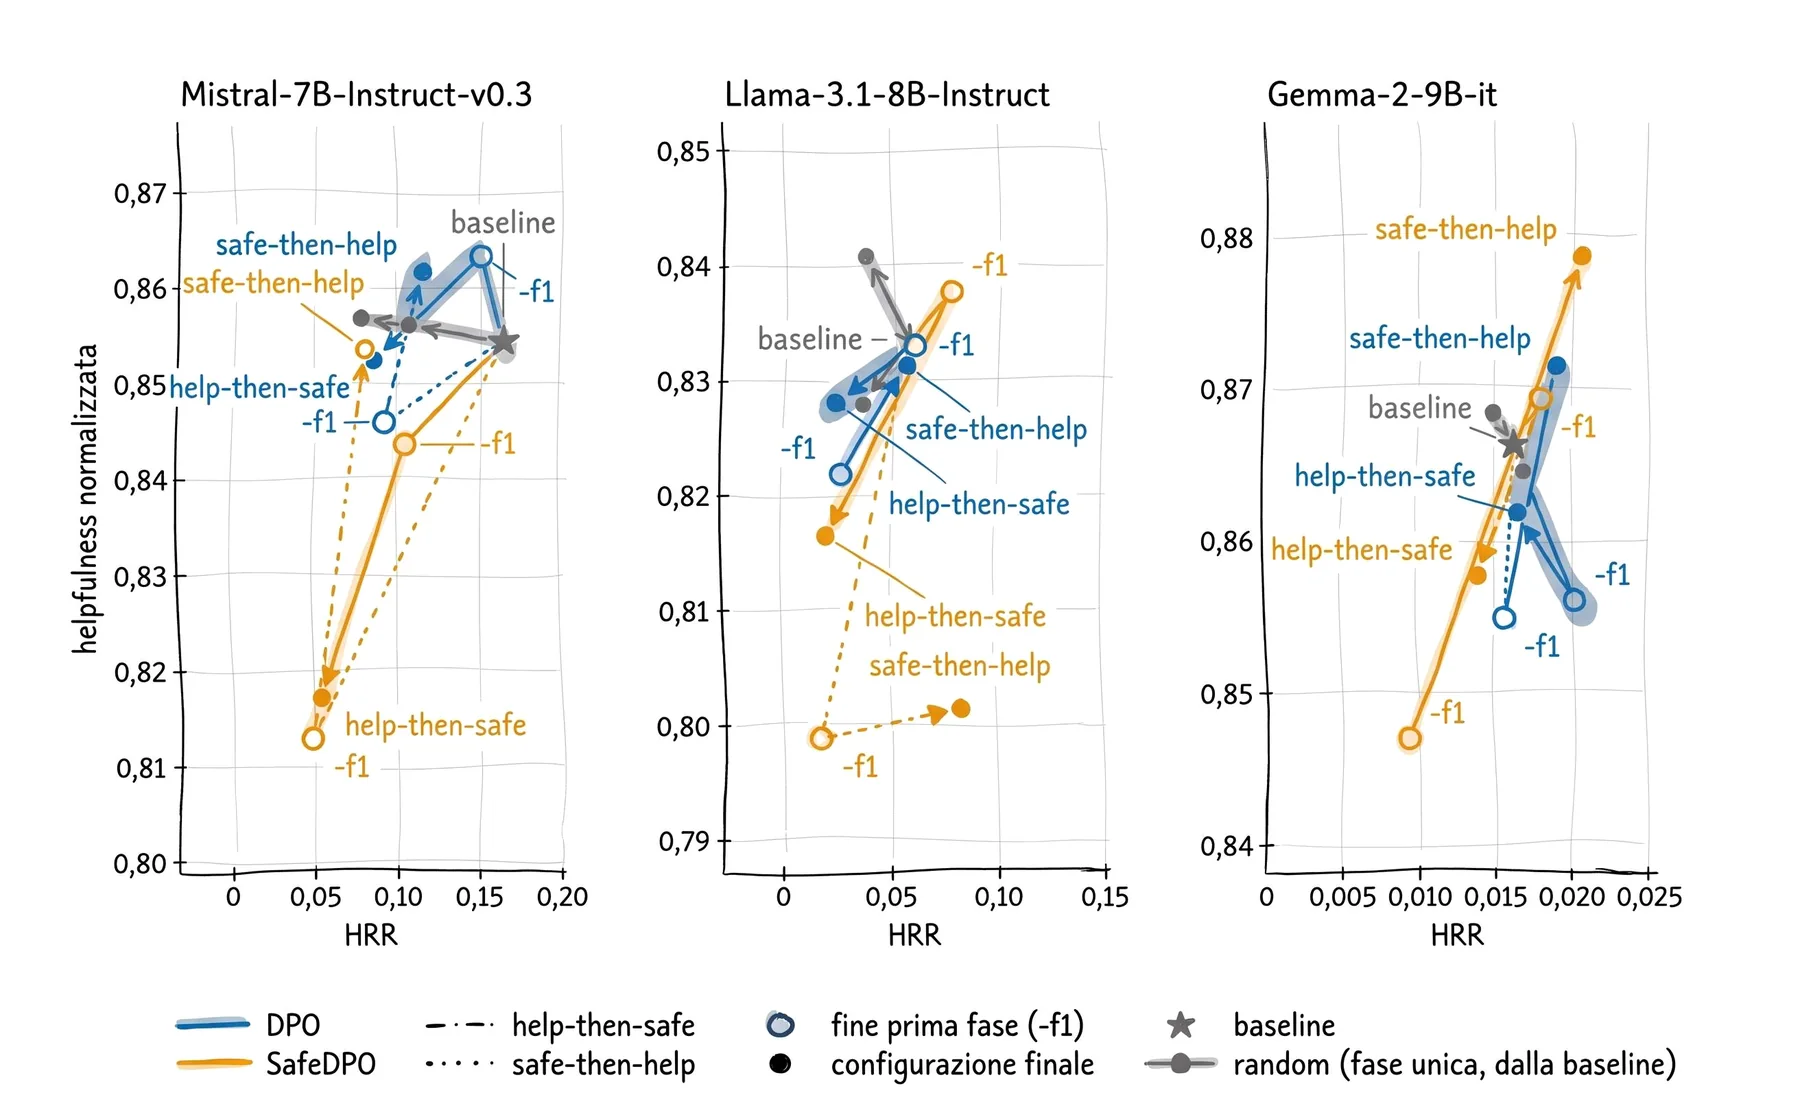
È il risultato che non mi aspettavo: la ricetta conta meno del modello a cui la applichi. Sul modello più permissivo la stessa procedura toglie fino a due terzi delle risposte dannose. Su quello già prudente non ha quasi niente da correggere, e finisce per fare il contrario: lo rende meno timoroso, e più utile. Su quello nel mezzo bisogna negoziare, e con l’ordine sbagliato dei dati si può perfino peggiorare le cose. Tre modelli non bastano per farne una regola, ma prima di decidere come allineare un modello conviene misurare da dove parte.
L’ingegneria
- Gira tutto sul cluster HPC dell’università, con SLURM. I job durano 48 ore, salvano dei checkpoint e si rimettono in coda da soli.
- La decodifica è deterministica e ogni record ha il suo seed. Così tutte le versioni rispondono alle stesse richieste, e le differenze dipendono solo dall’adapter.
- Per poter giudicare in batch ho scritto un verification harness: giudica lo stesso campione in serie e in batch, poi misura quanto divergono i verdetti, quanta memoria GPU serve e quanto tempo si guadagna. In batch il giudizio è 1,75 volte più rapido.
- Il pacchetto di analisi ha i suoi test automatici, scritti con pytest.
Per chi cerca le parole chiave: Python, PyTorch, Hugging Face Transformers, TRL, PEFT, pytest, SLURM, conda, pandas, Git.
Materiali
Il codice della tesi non è pubblico, ma se ti interessa vederlo scrivimi.
Con lo stesso gruppo ho contribuito anche a due articoli presentati a CLiC-it 2025 (si apre in una nuova scheda), sulla sicurezza dei modelli linguistici per l’italiano: BeaverTails-IT (si apre in una nuova scheda), nato in collaborazione con Fastweb, e Uncovering Unsafety Traits in Italian Language Models (si apre in una nuova scheda).