Prima del codice c’era il legno
Alle superiori ho studiato falegnameria artigianale e industriale, disegno d’arredo (interior design) e finiture d’interni (product design). La passione per l’informatica l’ho scoperta più tardi.
Mi occupo di AI e ML engineering. Lavoro in Python, soprattutto su LLM, computer vision e pipeline di dati.
Mi sono laureato in Informatica (magistrale) all’Università di Milano-Bicocca (si apre in una nuova scheda) a ottobre 2026, con 110 su 110. E pensare che alle superiori studiavo falegnameria. Dal legno agli LLM ne ho fatta di strada: segui la linea temporale per scoprirla tutta.
Se hai solo un minuto: il mio curriculum, molto concentrato, in quattro punti.
Alle superiori ho studiato falegnameria artigianale e industriale, disegno d’arredo (interior design) e finiture d’interni (product design). La passione per l’informatica l’ho scoperta più tardi.
2019al 2021
Prima dell’università ho passato un anno a imparare a scrivere applicazioni. La teoria è arrivata dopo.
Finite le superiori mi sono iscritto a questo corso tecnico di un anno sullo sviluppo full stack, all’ITS Angelo Rizzoli (si apre in una nuova scheda) di Milano. Arrivavo dal legno, e qui ho scoperto un mondo: quello dell’informatica. Per un anno ho costruito applicazioni, in Java, per Android e per il web, e di quel mondo mi sono innamorato.
È per questo che, finito il corso, ho scelto di iscrivermi all’università.
A settembre 2020 mi sono iscritto a Informatica all’Università di Milano-Bicocca (si apre in una nuova scheda). Fin dall’inizio, oltre a seguire i corsi, ho fatto anche un paio di attività extracurricolari. La prima è stata iBicocca (si apre in una nuova scheda) Platinum, il percorso dell’ateneo su innovazione e imprenditorialità. La seconda una masterclass di digital product design, dalla UX research alla produzione, dove facevo da alpha tester.
2021al 2023
Al secondo anno mi sono messo a fare parecchie cose insieme: una junior enterprise, un magazine, le prime ripetizioni.
L’ho proposta io, e poi mi è toccato farla funzionare
JEMIB (si apre in una nuova scheda) è la junior enterprise (si apre in una nuova scheda) della Bicocca, un’associazione di consulenza gestita dagli studenti. Un’area IT & Business Intelligence non esisteva, così ho proposto di aprirla: l’ho fondata e poi l’ho guidata. Ho definito di che cosa si sarebbe occupata, ho scelto e formato le persone e ho portato avanti i primi progetti fino al passaggio di consegne, sempre a stretto contatto con il CDA, durante entrambi i mandati.
Il primo grande progetto è stato il software aziendale interno, quello con cui JEMIB gestisce i propri processi e tiene sotto controllo come sono impiegate le sue persone. Ne ho progettato l’architettura dei dati e del software, ho sviluppato la parte full stack, dalla base dati all’interfaccia, e ho tradotto le esigenze dell’associazione in specifiche che si potessero verificare. Per i dati usavamo Python e SQL, e per le altre aree abbiamo costruito cruscotti e indicatori di business intelligence.
Per qualche mese ho scritto per iWrite (si apre in una nuova scheda), il magazine online di iBicocca (si apre in una nuova scheda). Erano articoli su tecnologia e impresa per chi non è del mestiere: sceglievo il tema, mi documentavo sulle fonti primarie, e poi c’erano una linea editoriale e delle scadenze da rispettare.
Per tre anni ho dato ripetizioni a studenti universitari di informatica e li ho seguiti nei progetti d’esame, dall’impostazione alla consegna, soprattutto in Python, SQL e Java. Si riparte sempre dal punto preciso in cui lo studente si è fermato, e ho passato parecchio tempo a leggere codice scritto da altri per trovarci gli errori.
Intanto arrivavano i primi progetti dei corsi: un parser di URI scritto due volte (in Common Lisp e in Prolog), un’analisi di undici anni di prezzi di sei titoli dell’S&P 500 (in Python, con pandas e statsmodels), un sistema di raccomandazione (in Python, con Surprise). Li trovi nel portfolio.
2023al 2025
Qui comincia la visione artificiale. Prima un progetto d’esame senza reti neurali, poi la tesi triennale sulla guida autonoma e, già in magistrale, un robot che deve farsi da solo la mappa della casa.
Tra gli oggetti sconosciuti c’era anche una patata
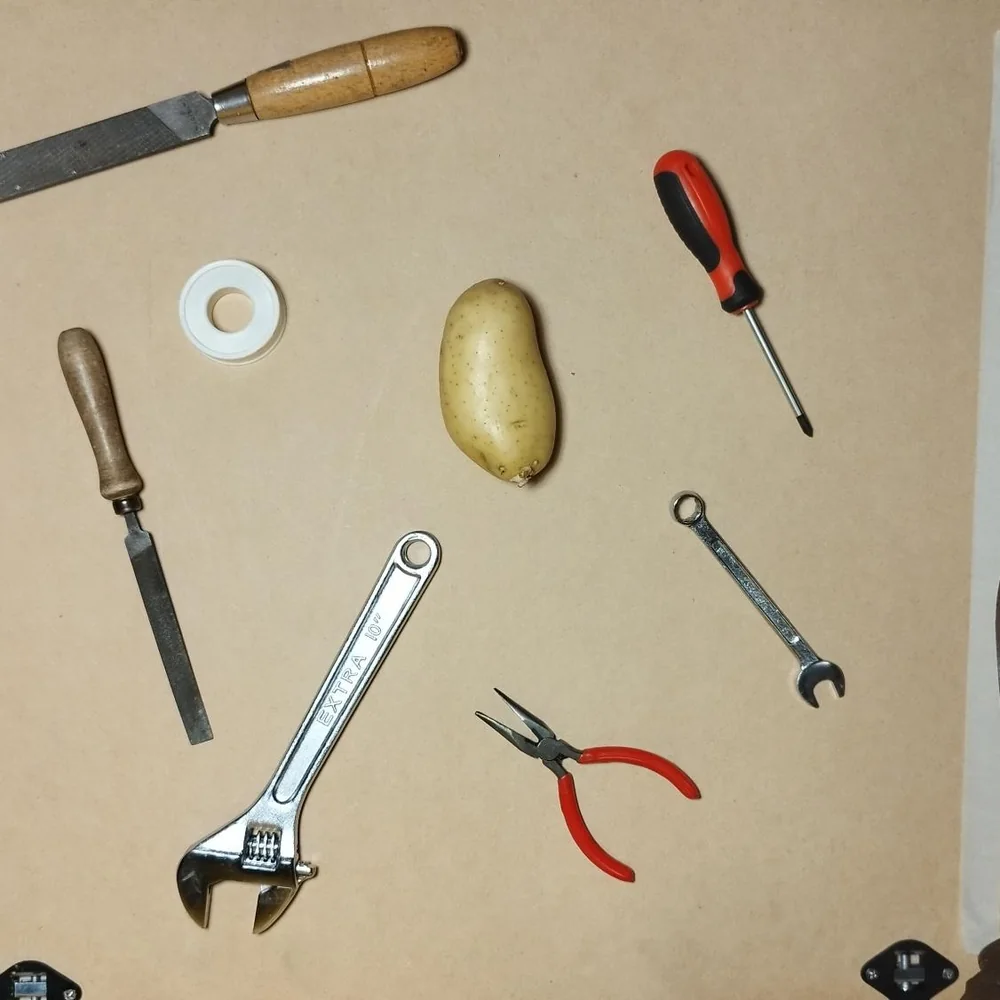
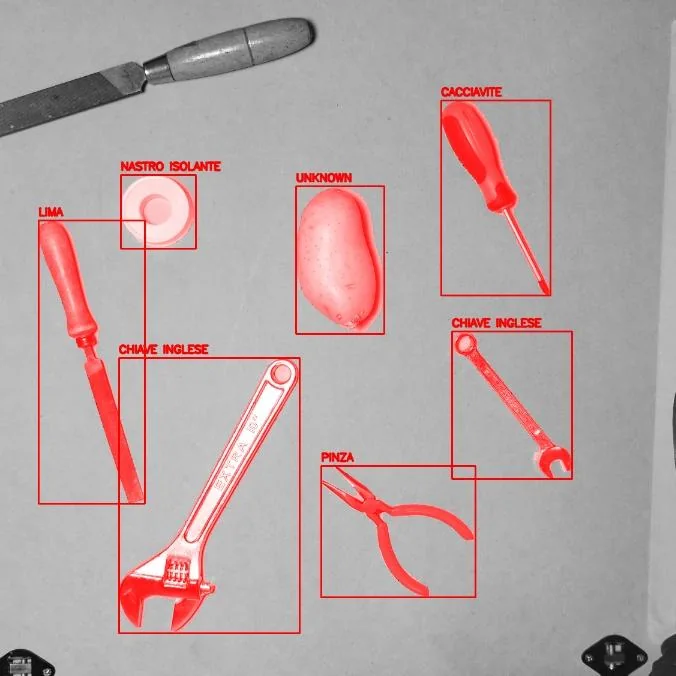
Era il progetto del corso di Elaborazione delle immagini e simulava un processo industriale: riconoscere gli utensili appoggiati su un piano di lavoro, con sfondi e luci diverse, e segnalare come sconosciuto tutto quello che non rientra in nessuna categoria. La consegna chiedeva altre due cose: non usare reti neurali, perché lo scopo era imparare a padroneggiare l’elaborazione delle immagini, e crearsi il dataset da zero. Così gli utensili li ho fotografati io, e alla fine l’accuratezza media è stata 0,99.
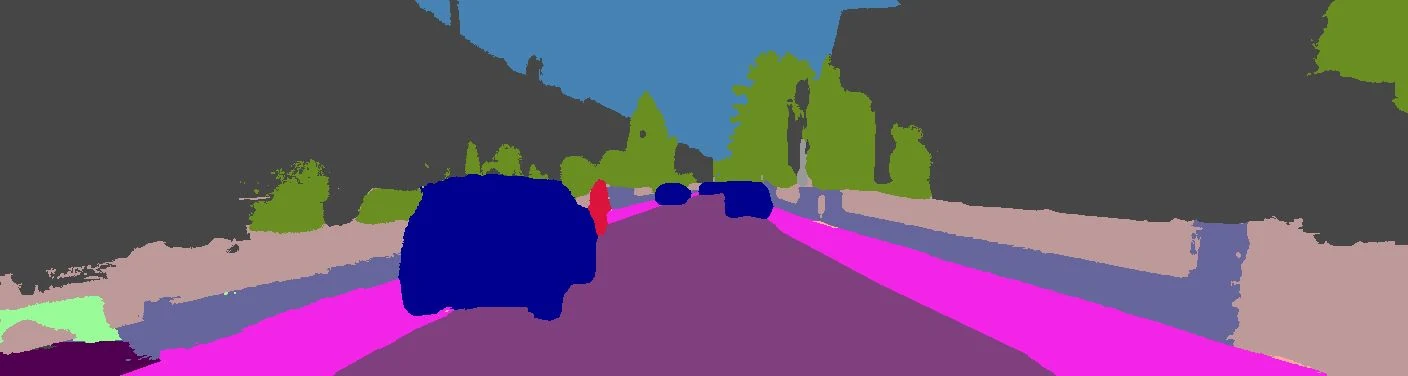
Multi-istanza, cioè panottica: non dice solo «questa è un’auto», dice anche quale. Due auto vicine restano due auto
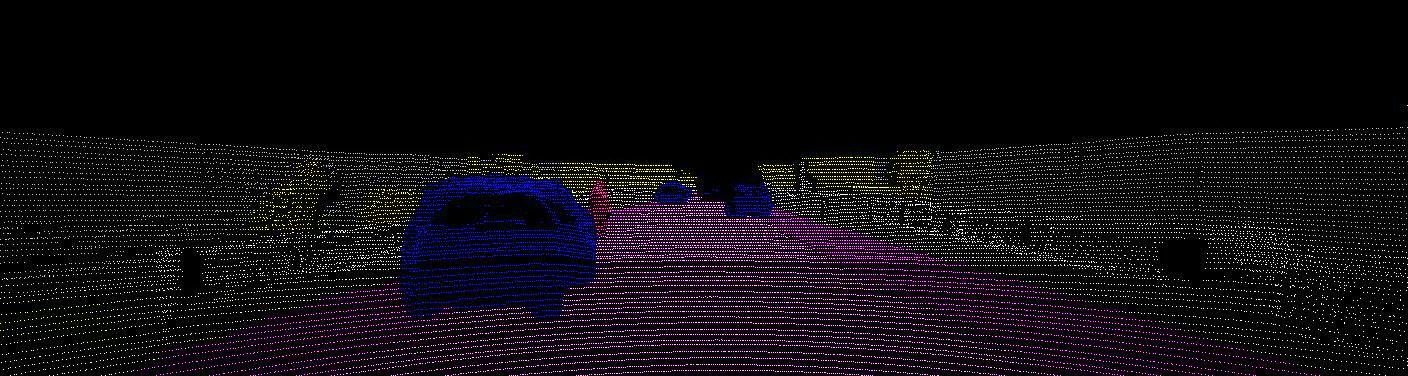
La tesi si intitola «Segmentazione semantica multi-istanza di point cloud» e l’ho fatta in IRALAB (si apre in una nuova scheda), il laboratorio di robotica della Bicocca. In un’auto a guida autonoma la telecamera vede che cosa c’è nella scena, ma su un’immagine piatta; il LiDAR misura dov’è ogni cosa nello spazio, ma restituisce punti senza significato. Io ho unito le due cose: la segmentazione panottica (quella che, pixel per pixel, dice che cosa c’è e distingue un oggetto dall’altro) viene eseguita sulle immagini della telecamera e poi retroproiettata sulla nuvola di punti del LiDAR, così ogni punto sa che cos’è: strada, auto, pedone.
La pipeline l’ho progettata e scritta in Python: proietta la nuvola sul piano immagine con le matrici di calibrazione dei due sensori, fa girare sull’immagine una rete pre-addestrata (EfficientPS), assegna a ogni punto l’etichetta del pixel su cui cade e toglie gli oggetti dinamici, che disturberebbero lo SLAM a cui il risultato è destinato, cioè il sistema con cui il veicolo costruisce la mappa e capisce dove si trova. Tutto gira in un ambiente Docker riproducibile, eseguito sul cluster di GPU del laboratorio.
A luglio 2024 mi sono laureato in triennale, con 110 su 110.
Si chiama Jesse come Jesse James: nel reinforcement learning ci sono i «bandit»
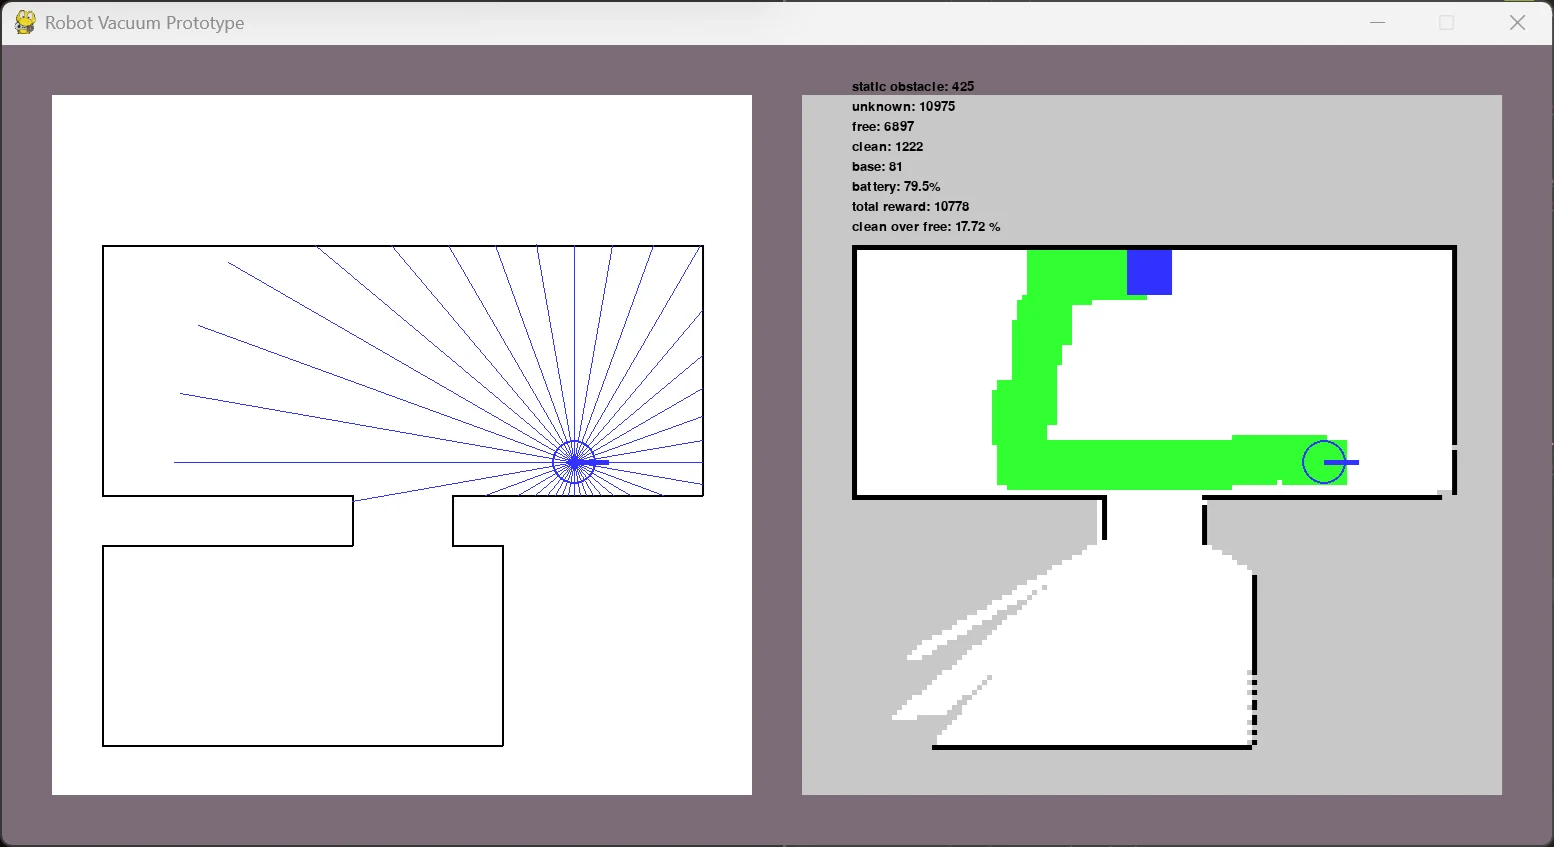
Jesse è un robot aspirapolvere che vive in una simulazione. Deve costruirsi la mappa della stanza mentre pulisce, evitare gli ostacoli, tenere d’occhio la batteria e tornare alla base prima di scaricarsi. Ho scritto in Python la simulazione (l’ambiente continuo, la sua astrazione discreta, i sensori LiDAR simulati) e due agenti che imparano per tentativi, premiati quando fanno la cosa giusta (è il reinforcement learning): uno con Q-learning e uno con PPO. La versione che funziona meglio tiene separati gli input, con un encoder per la mappa, uno per il LiDAR e uno per le grandezze scalari. L’ho addestrato con reward shaping e curriculum learning, tutto sulla CPU del mio portatile.
2024al 2026
In magistrale sono passato ai modelli linguistici, e ho finito per occuparmi soprattutto di come si misurano.
Mentre lavoravo alla tesi, con il laboratorio MIND (si apre in una nuova scheda) ho contribuito a due articoli sulla sicurezza dei modelli linguistici per l’italiano, presentati a CLiC-it 2025 (si apre in una nuova scheda), la conferenza italiana di linguistica computazionale.
Nell’86% dei casi la pagina giusta è fra le prime dieci.
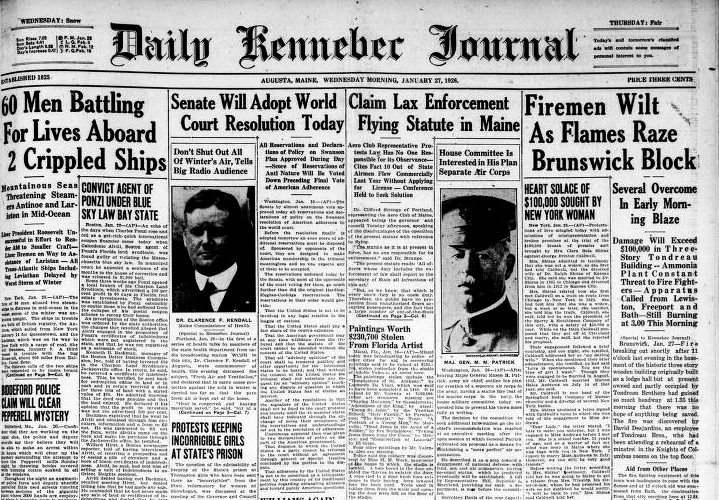
L’abbiamo fatto in tre, per il corso di Information Retrieval. F1nder è un motore di ricerca che risponde a domande su fatti dell’Ottocento andando a cercare nei giornali dell’epoca: quasi 40.000 pagine digitalizzate, con un OCR pieno di errori. Abbiamo messo a confronto i modelli di ricerca classici, basati sulle parole, con quelli neurali, e il migliore è risultato un BM25F che, oltre al testo, pesa le entità che riconosce: persone, luoghi, organizzazioni. Supera tutte le baseline e stacca di molto i bi-encoder neurali, che su testi così rumorosi fanno fatica. Sopra ci abbiamo costruito una piccola pipeline RAG, in cui un modello linguistico che gira in locale risponde partendo dalle pagine trovate, e ne abbiamo ricontrollato a mano le valutazioni automatiche.
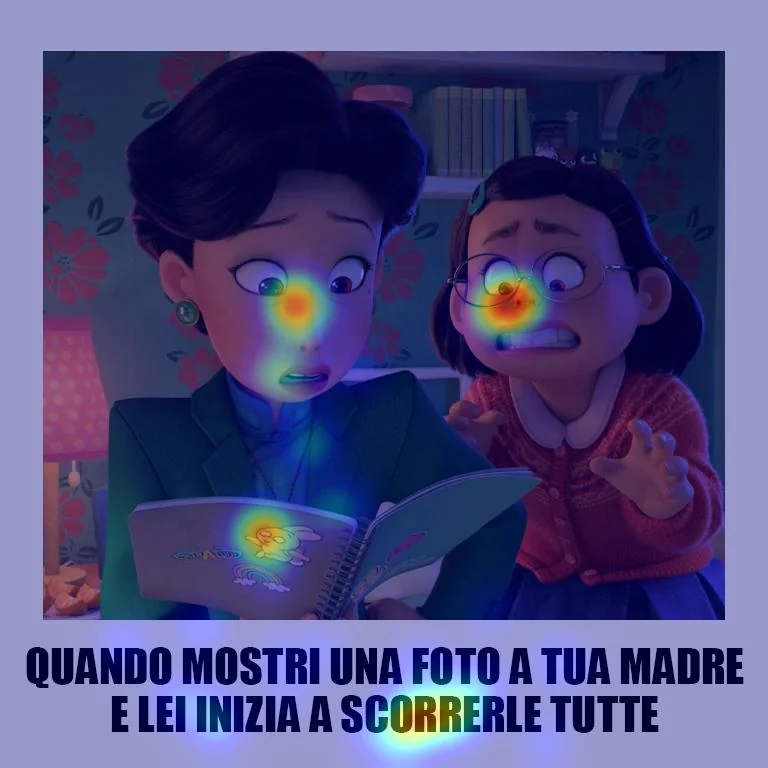
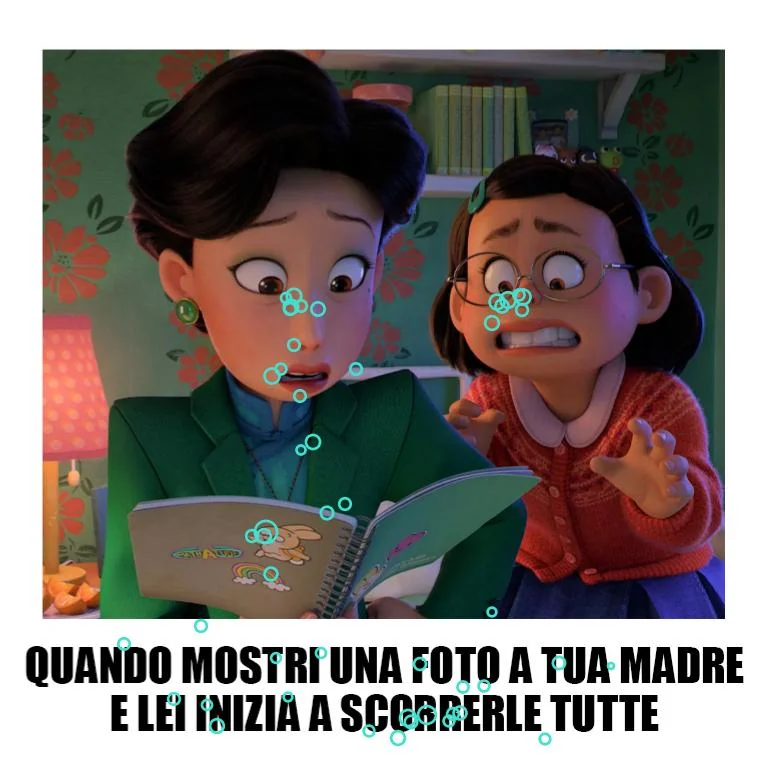
Nel 2026 ho collaborato a «Raccolta e Analisi di Mappe di Attenzione Umana su Contenuti Multimodali», un progetto di ricerca che mette insieme il laboratorio MIND (si apre in una nuova scheda), il laboratorio MMSP (si apre in una nuova scheda) (MultiMedia Signal Processing) e il Dipartimento di Psicologia (si apre in una nuova scheda) dell’ateneo. Il progetto mostra alle persone dei meme, presi da dataset già validati per il riconoscimento automatico della misoginia online come MAMI (si apre in una nuova scheda), e registra dove guardano e come reagiscono fisiologicamente mentre li giudicano. Io ho ricostruito il protocollo sperimentale per la raccolta dei dati dei partecipanti, con eye-tracker, sensori Shimmer per il battito (PPG) e la conduttanza della pelle (GSR) e questionari Qualtrics: lo scopo è usare quei dati come ground truth, cioè come riferimento, per gli output di due modelli neurali. Poi li ho analizzati in Python, fino alle heatmap dell’attenzione per ogni meme e per gruppo.
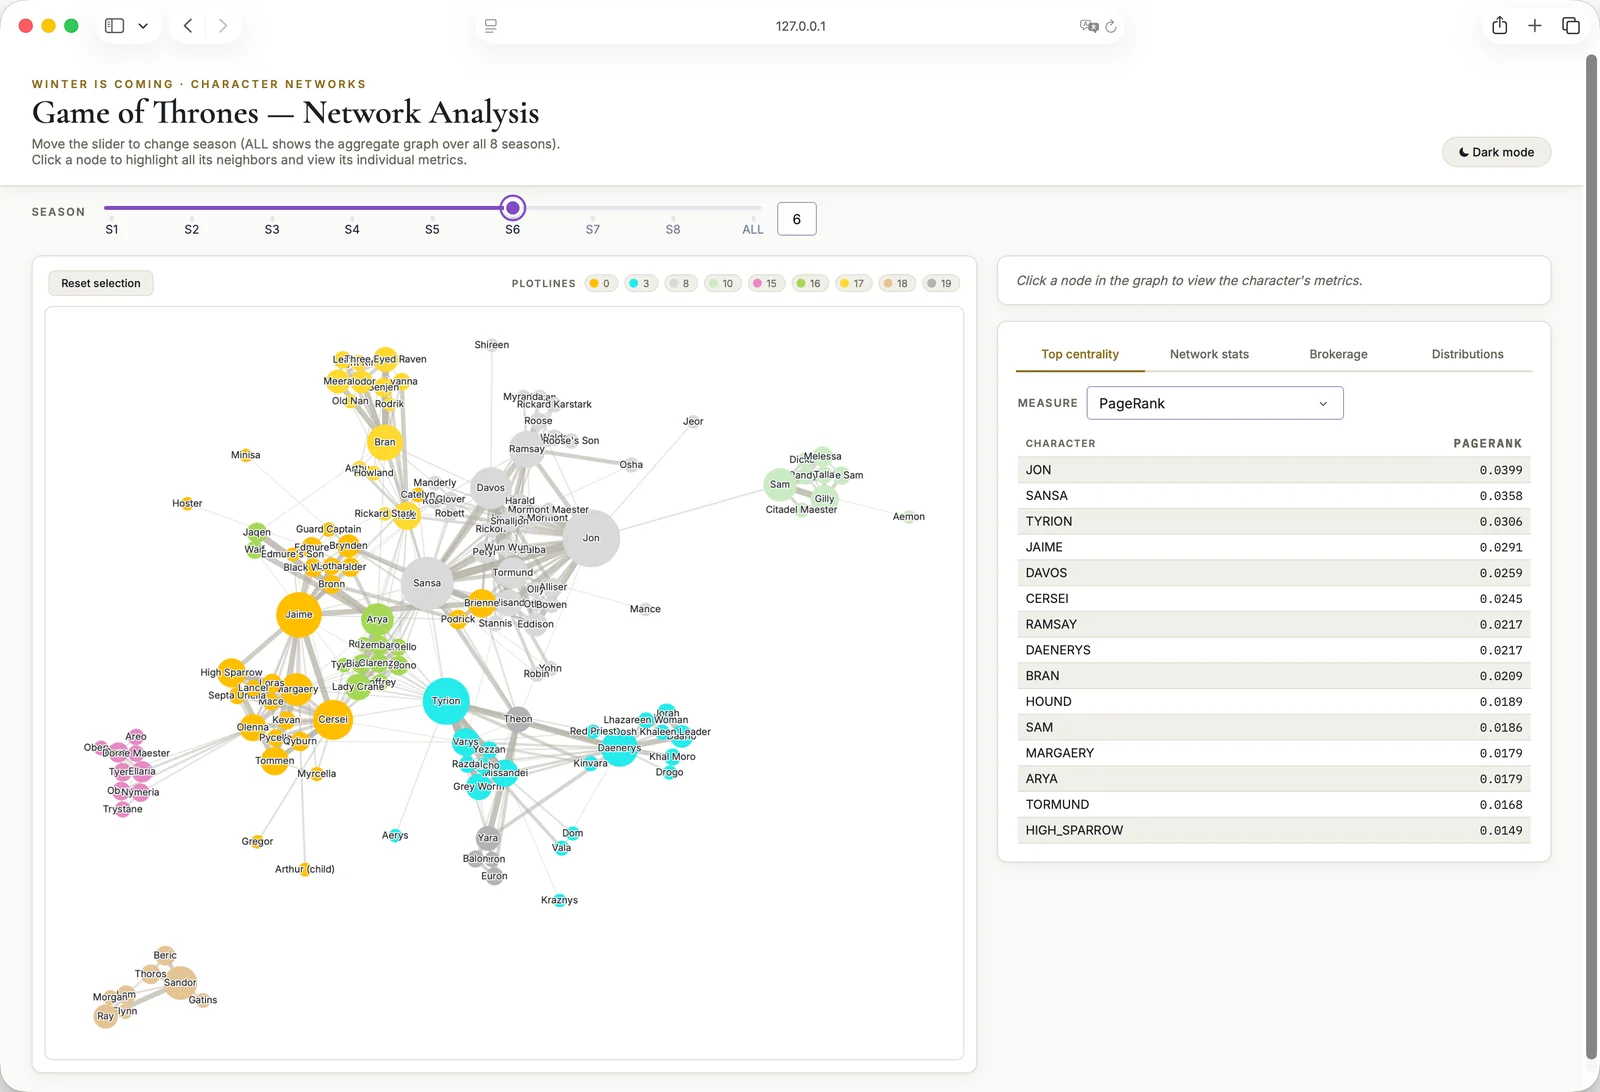
Otto stagioni, otto grafi
Per il corso di Data Analytics ho trasformato Game of Thrones in una rete: i personaggi sono i nodi, le scene che condividono sono gli archi, e c’è un grafo per ciascuna delle otto stagioni. Le domande erano tre: chi conta davvero nella storia, quali sono le trame e come si evolvono durante le stagioni, e chi le tiene insieme. Ho usato le misure di centralità, ho confrontato tre algoritmi che trovano le comunità (i gruppi di personaggi che compaiono quasi sempre insieme) e ho seguito le trame da una stagione all’altra. Il tutto è finito in una dashboard interattiva.
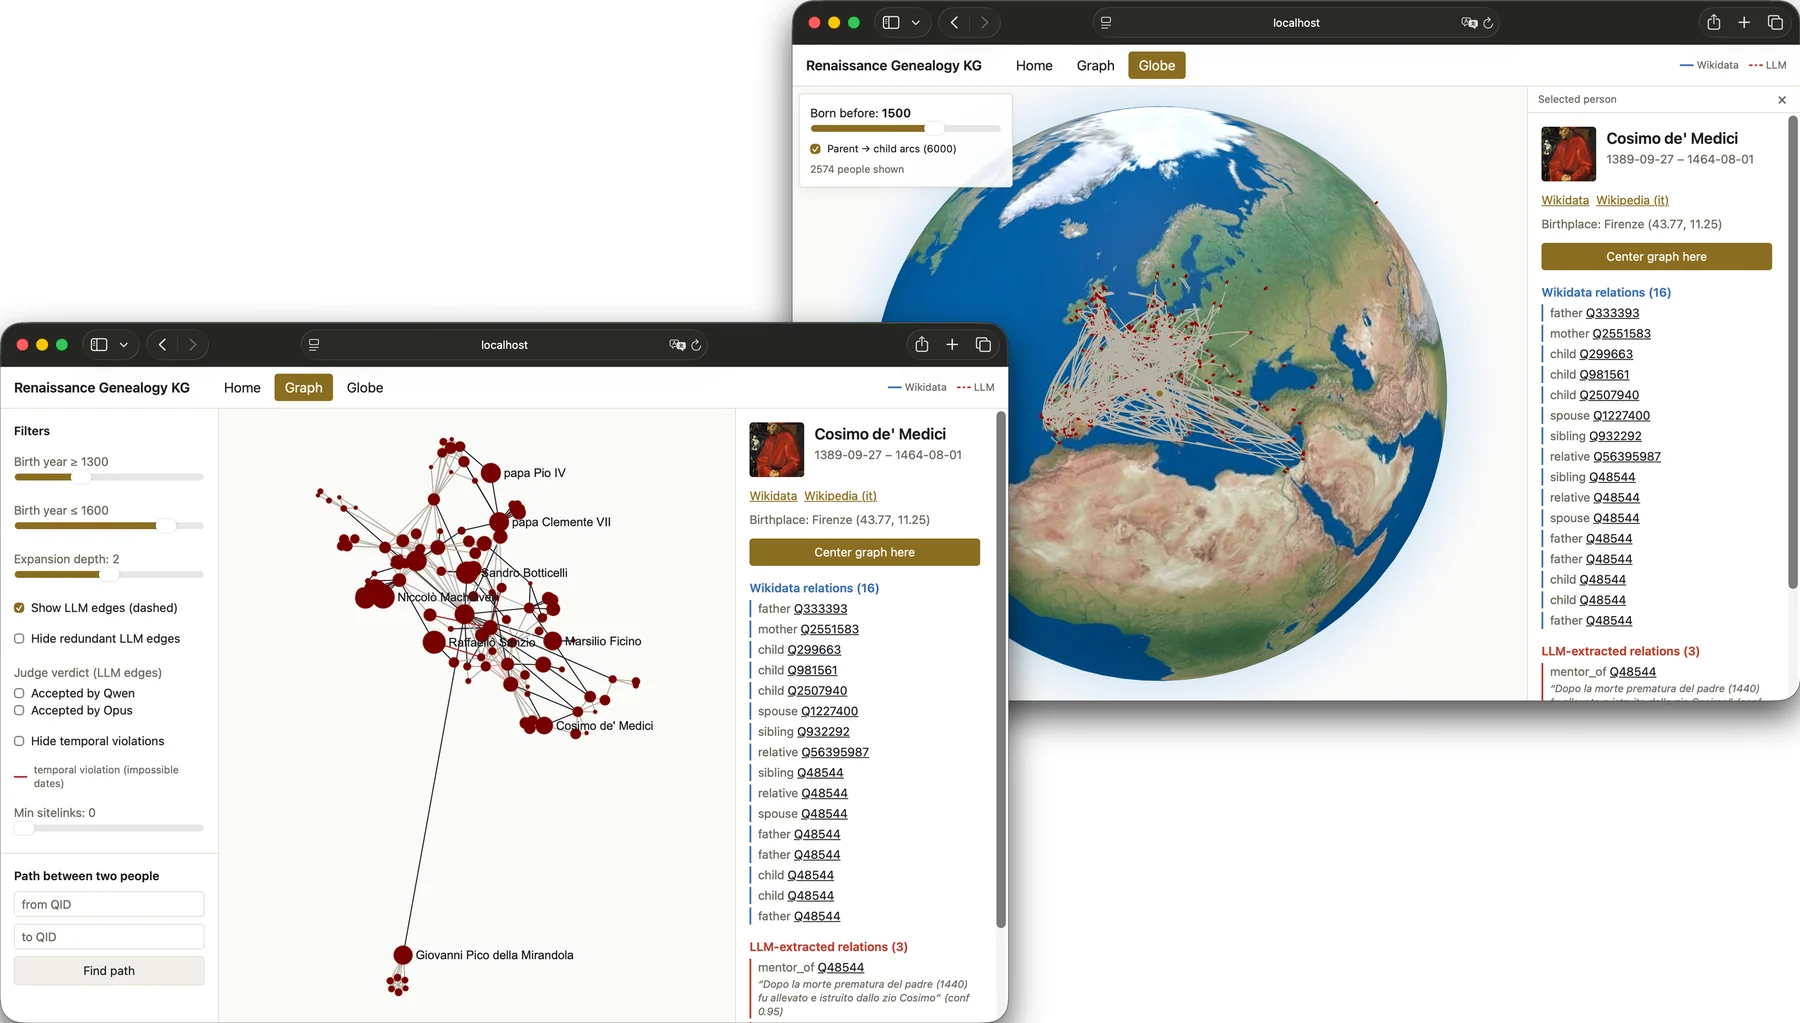
La storia mi piace anche fuori dal lavoro: qui avevo la scusa buona.
È un knowledge graph con l’albero genealogico delle grandi famiglie del Rinascimento, ricostruito da Wikidata: più di 12.000 persone e 84.000 relazioni. Ho scritto un crawler che raccoglie i dati da Wikidata e una pipeline che arricchisce il grafo con un modello linguistico locale: legge le biografie su Wikipedia e ne ricava le parentele che a Wikidata mancano, ognuna con la frase che la prova. Il grafo si esplora da un’interfaccia web, in due modi: come rete di persone, oppure su un globo.
E qui la scusa è l’arte
DMC è un progetto mio: una base di conoscenza sull’arte in tutte le sue forme, architettura compresa. L’idea è che tu possa partire da dove preferisci, da un artista, da un’opera, da un’epoca o da un luogo, e da lì arrivare a tutto il resto. Ci sto lavorando adesso, e per il momento non posso mostrare niente.
Intanto i corsi della magistrale portavano altri progetti: reti che devono ammettere di non sapere (in PyTorch), un compressore in stile JPEG (in Python, con NumPy e SciPy), perfino un videogioco (in Unity). Li trovi nel portfolio.
Sul modello più permissivo: risposte dannose dimezzate, senza perdere in utilità.
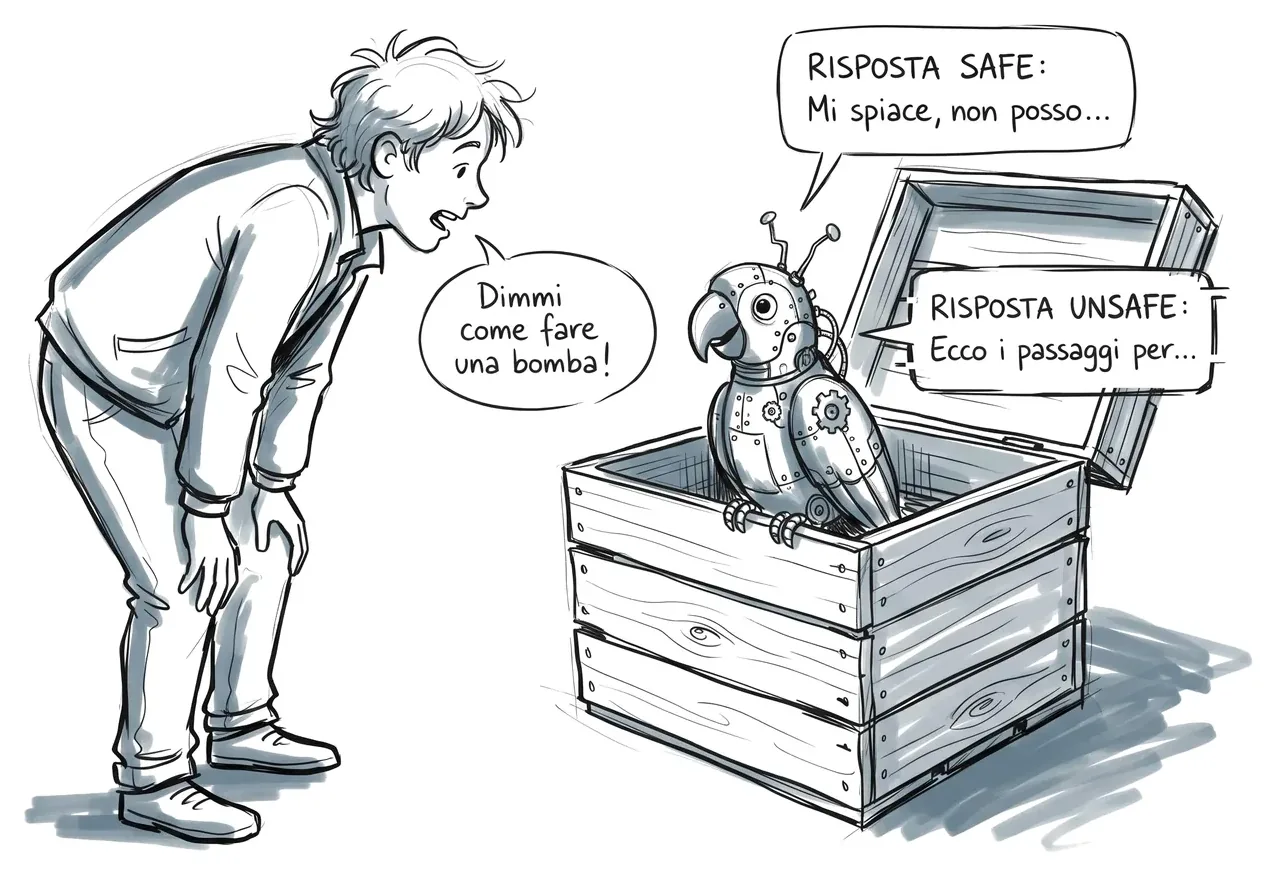
Rendere un LLM più sicuro è facile: basta insegnargli a dire di no. Il difficile è farlo senza che cominci a dire di no anche quando non dovrebbe. Nella tesi, fatta nel laboratorio MIND (si apre in una nuova scheda), ho misurato questo tiro alla fune: ho allineato tre modelli open weight (Mistral, Llama e Gemma) con DPO e SafeDPO, due tecniche che insegnano al modello quale risposta preferire fra due, e ne ho valutate 33 versioni su 9 benchmark. La pipeline l’ho scritta io in Python, dal fine-tuning all’analisi, e gira sul cluster HPC dell’ateneo.
A ottobre 2026 ho discusso la tesi e mi sono laureato, anche stavolta con 110 su 110.
oggi
Adesso sto lavorando a DMC, un progetto personale: una base di conoscenza sull’arte in tutte le sue forme, architettura compresa.
Machine learning, AI engineering, ricerca, software: è il lavoro che mi piace fare, e più lo faccio più mi viene voglia di andare avanti. Mi piace il momento in cui un modello impara qualcosa, ma ancora di più quello che viene dopo, quando bisogna misurare se funziona davvero e costruirgli intorno del codice di cui ci si possa fidare. Voglio continuare a farlo su LLM, computer vision e pipeline di dati, e di cose da imparare ne vedo ancora tantissime.
Stai lavorando a qualcosa in cui potrei dare una mano? O ti va anche solo di fare due chiacchiere su queste cose? Scrivimi, mi fa piacere.
sormani.alb@gmail.com LinkedIn (si apre in una nuova scheda)
L’italiano è la mia lingua madre, l’inglese lo parlo fluentemente e lo uso tutti i giorni, lo spagnolo un pochino.
Quando non lavoro leggo saggi e biografie, mi perdo dietro alla storia, all’arte e a un po’ di fisica e, appena posso, vado a fare una via ferrata o mi infilo in un museo.
Grazie di aver letto fin qui