Dare un nome a ogni punto
È la mia tesi triennale in Informatica. L’ho fatta in IRALAB (si apre in una nuova scheda), il laboratorio di informatica e robotica per l’automazione dell’Università di Milano-Bicocca (si apre in una nuova scheda), tra marzo e luglio 2024. Il titolo vero è «Segmentazione semantica multi-istanza di point cloud».
Il relatore era Domenico Giorgio Sorrenti, il correlatore Matteo Vaghi. Li ringrazio tutti e due.
Il problema
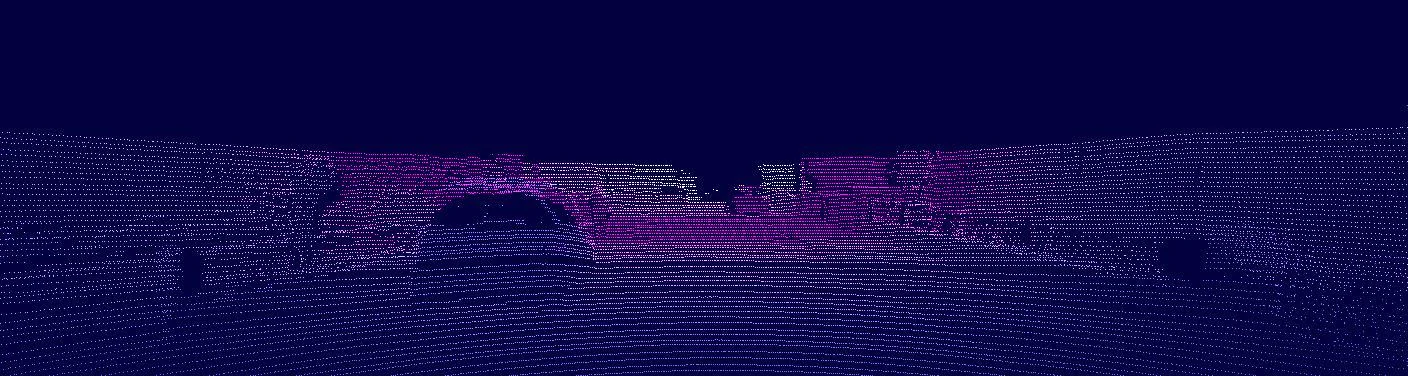
Un’auto a guida autonoma deve capire che cosa ha intorno, e per farlo usa sensori diversi. La telecamera vede che cosa c’è nella scena: una rete neurale sa dire, pixel per pixel, dove sono la strada, le auto, i pedoni. Ma un’immagine è piatta. Il LiDAR fa il contrario: misura con precisione dov’è ogni cosa nello spazio e restituisce una nuvola di punti in tre dimensioni, dove però un punto è solo un punto, senza significato.
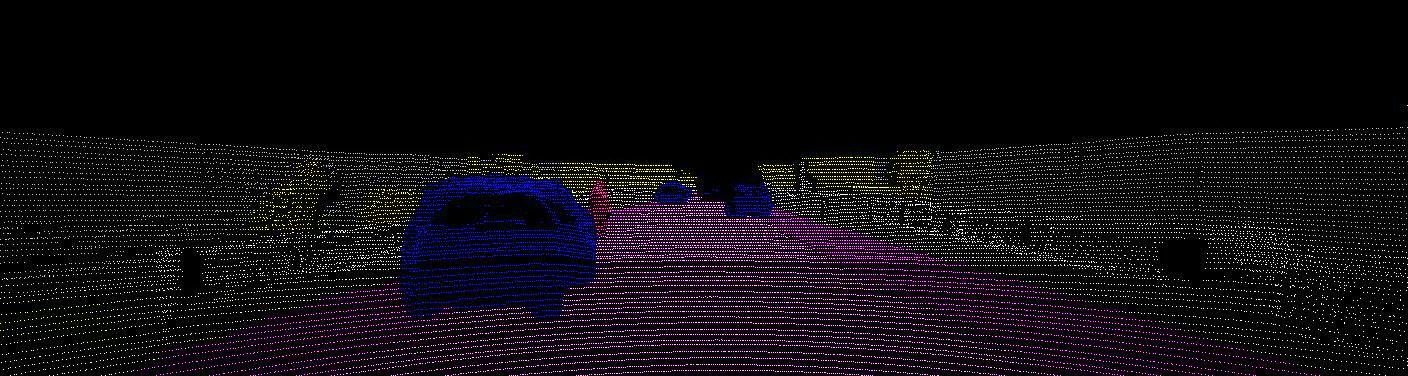
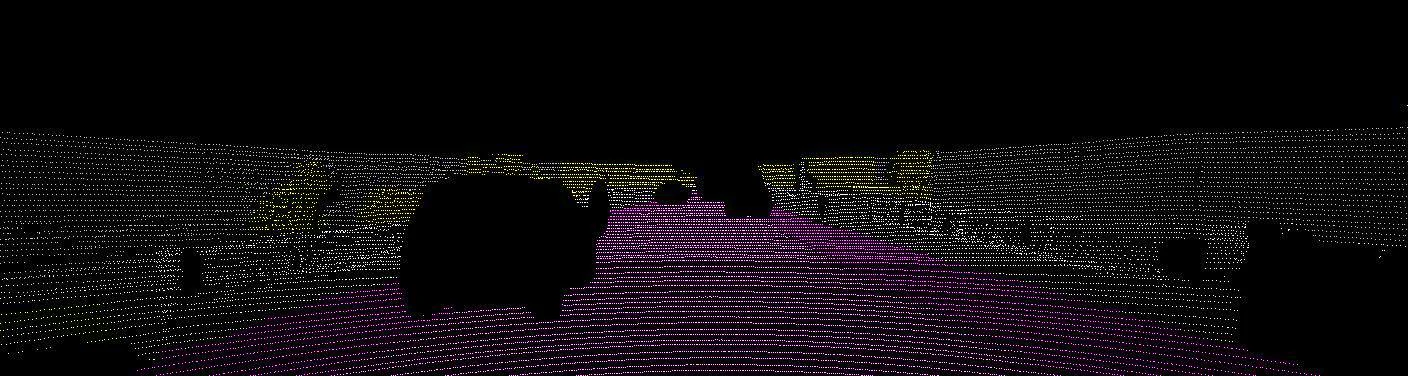
La tesi mette insieme le due cose. La segmentazione viene eseguita sulle immagini della telecamera e poi retroproiettata sulla nuvola di punti, così ogni punto del LiDAR sa che cos’è. Il risultato è pensato per entrare in una pipeline più ampia di SLAM, cioè un sistema con cui il veicolo costruisce la mappa di un ambiente che non conosce e intanto capisce dove si trova.
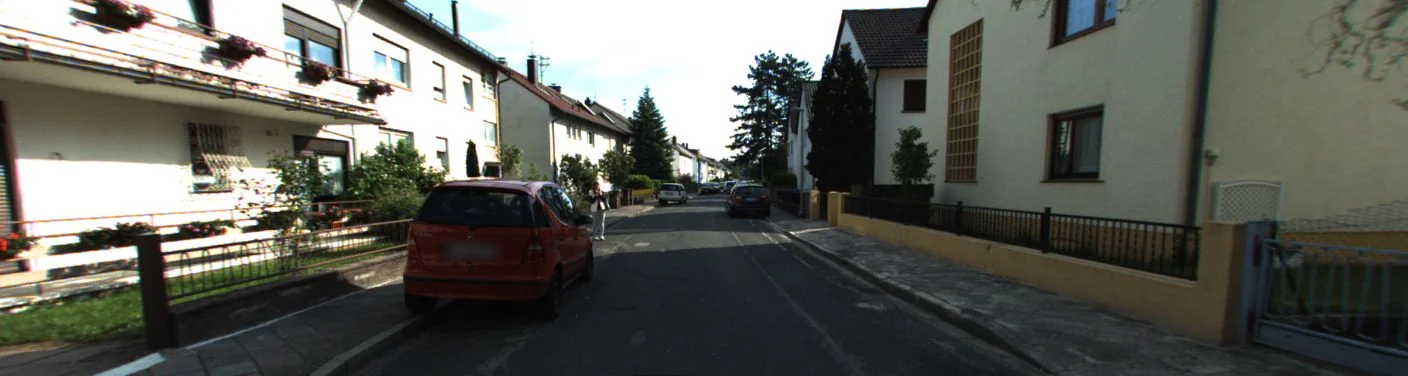
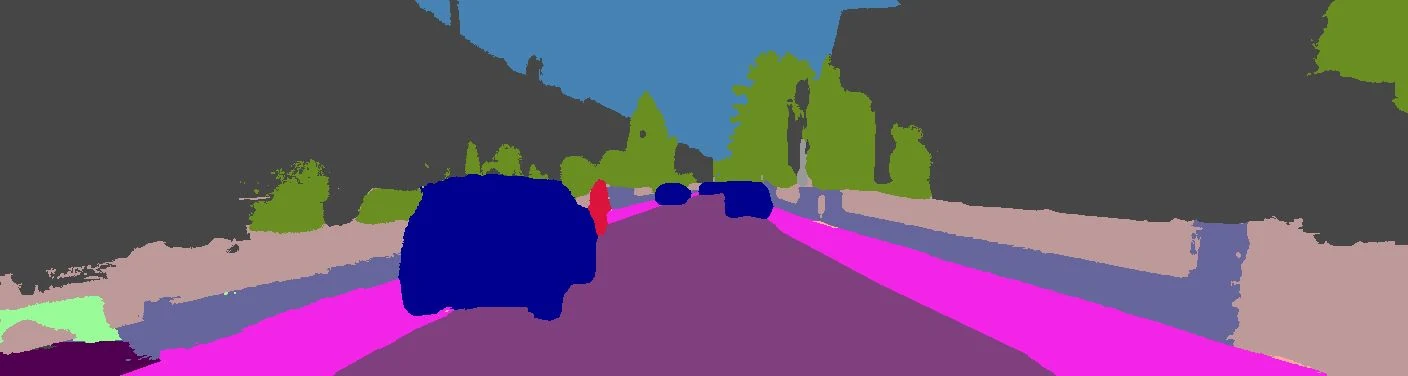
«Multi-istanza» perché la segmentazione che uso è quella panottica. La segmentazione semantica dice che certi pixel sono «auto»; quella panottica dice anche quale auto, cioè tiene separate due auto parcheggiate una accanto all’altra.
La pipeline
La pipeline l’ho progettata e scritta in Python. Per ogni scansione del LiDAR fa questi passaggi.
- Carica la scansione del LiDAR e l’immagine della telecamera scattata nello stesso istante.
- Proietta la nuvola di punti sul piano dell’immagine. Servono due cambi di sistema di riferimento, dal LiDAR alla telecamera e dalla telecamera all’immagine: li fa con le matrici di calibrazione dei due sensori, in un solo prodotto in coordinate omogenee. Il LiDAR vede a 360 gradi e la telecamera no, quindi restano solo i punti che cadono dentro l’inquadratura.
- Fa girare sull’immagine EfficientPS, una rete convoluzionale per la segmentazione panottica, in una versione pre-addestrata su Cityscapes.
- Assegna a ogni punto proiettato l’etichetta del pixel su cui cade.
- Toglie gli oggetti dinamici, come le auto e i pedoni. In una mappa le cose che si muovono sono rumore, e lo SLAM lavora meglio senza.
- Torna in tre dimensioni. In realtà non c’è niente da calcolare: di ogni punto proiettato tiene da parte le coordinate originali, quindi l’etichetta finisce direttamente sul punto 3D. La nuvola etichettata viene salvata in formato binario, per occupare meno spazio.
Quanto ci si può fidare
La qualità del risultato dipende tutta dalla rete che segmenta le immagini: se sbaglia un pixel, sbaglia anche il punto che ci cade sopra. Per addestrarne una nuova serviva più potenza di calcolo di quella che avevamo in laboratorio, così ho usato il modello pre-addestrato messo a disposizione dagli autori di EfficientPS e sono andato a misurare quanto fosse affidabile, contando i pixel classificati bene su tre dataset di città molto diverse fra loro.
| Dataset | Immagini | Accuratezza |
|---|---|---|
| Mapillary Vistas | 20.000 | 0,79 |
| Indian Driving Dataset | 7.884 | 0,79 |
| KITTI Panoptic Segmentation | 1.055 | 0,74 |
Poco meno dell’80%, più o meno ovunque. Ma il numero, da solo, racconta male come va il modello. Ogni dataset divide il mondo in classi a modo suo, e quando si convertono le etichette di un altro dataset in quelle che il modello conosce, tutto ciò che non trova una classe corrispondente finisce in «unlabeled». Il modello però una classe la assegna comunque, e ogni volta gli viene contato un errore.
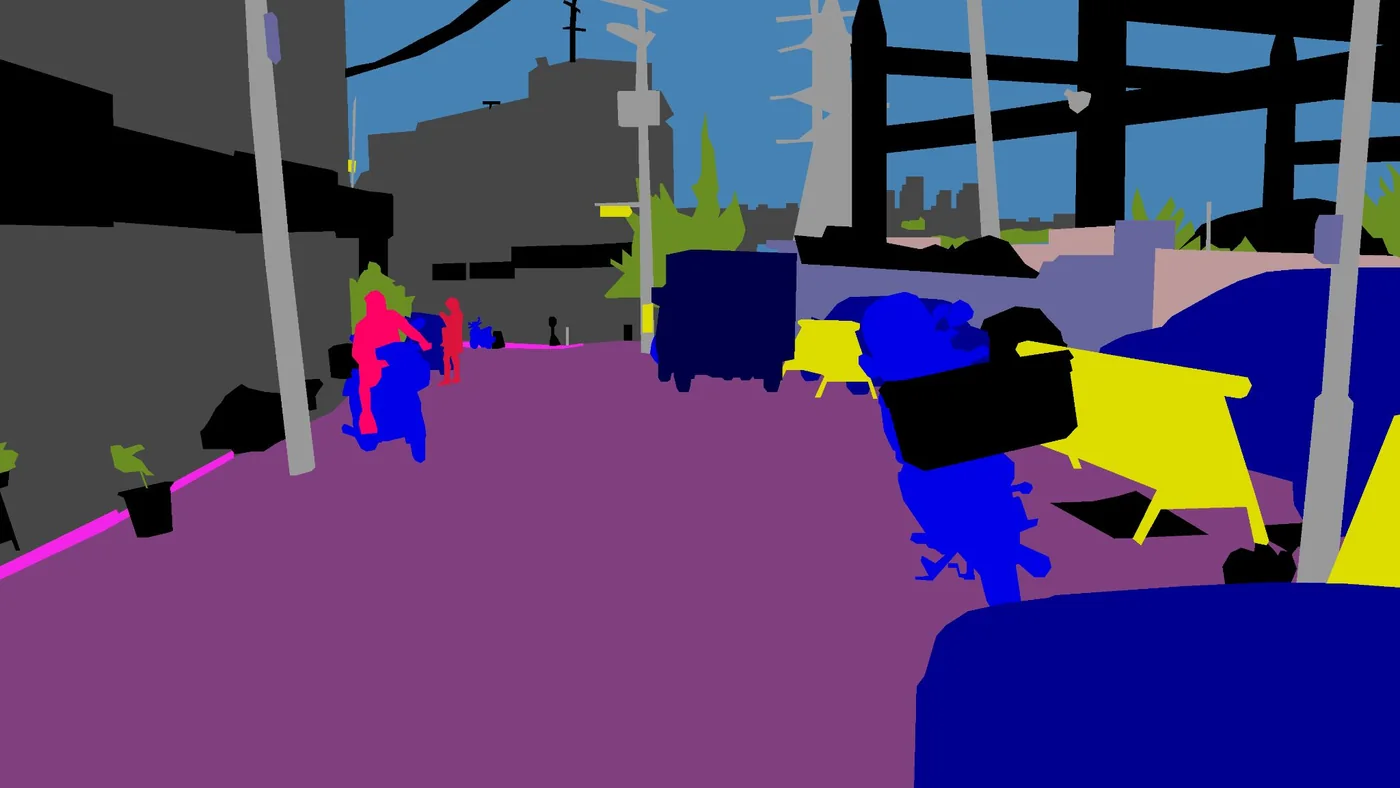
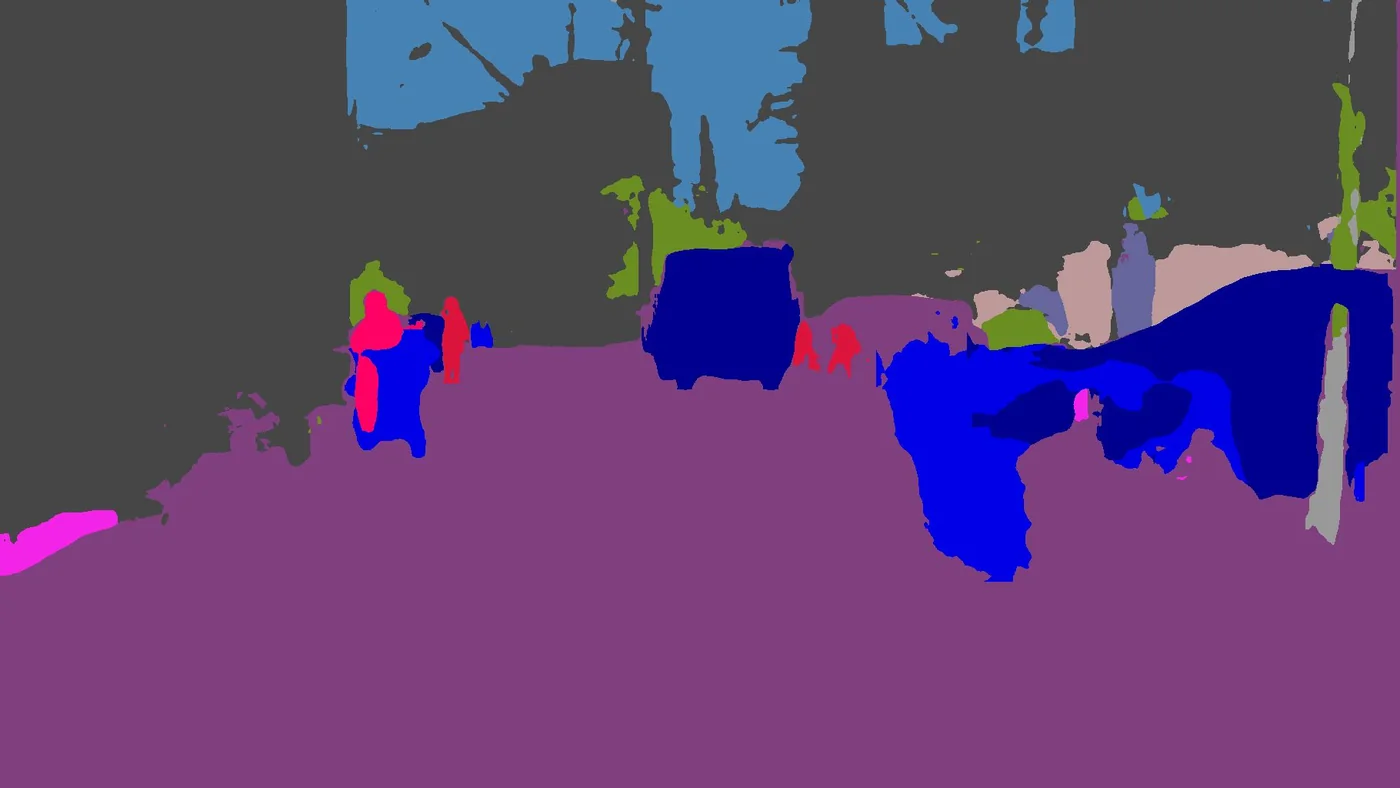
L’errore vero è un altro: il modello tende ad allargare un po’ gli oggetti che riconosce, e sui bordi fra una zona e l’altra sbaglia. C’è poi un limite nella metrica stessa, che conta i pixel: un’auto in primo piano pesa molto più di un pedone lontano, anche se per chi guida il pedone conta di più.
L’ingegneria
- Tutto gira in un ambiente Docker: bastano Docker e una GPU NVIDIA per rifare gli esperimenti su un’altra macchina.
- Il codice è una libreria Python, che ho chiamato IRAfunesta. Contiene la pipeline e due funzioni che fanno da interfaccia con EfficientPS: una carica il modello, l’altra fa l’inferenza su un’immagine.
- Ho lavorato con sei dataset di guida autonoma (KITTI, KITTI Panoptic Segmentation, KITTI-360, Cityscapes, Mapillary Vistas e Indian Driving Dataset) e ho scritto le mappature che convertono le etichette da un formato all’altro.
- Insieme al codice ho scritto la documentazione: come installare l’ambiente, come preparare il dataset, come usare la libreria.
Per chi cerca le parole chiave: Python, PyTorch, NumPy, OpenCV, Pillow, Matplotlib, Docker, NVIDIA CUDA, Ubuntu, Git.
Che cosa manca
È un punto di partenza, e nella tesi lo dico. Per ora ai punti assegno solo la classe, perché allo SLAM serve sapere quali oggetti togliere; la rete però distingue già le singole istanze, e aggiungerle alla nuvola è un passo breve. Il miglioramento più grande verrebbe da un modello addestrato su un dataset fatto apposta, e dall’aggiunta di altri sensori, come il radar.
Le scene di guida di questa pagina vengono da due dataset pubblici per la ricerca: KITTI-360 (si apre in una nuova scheda), distribuito con licenza CC BY-NC-SA 3.0, e Mapillary Vistas (si apre in una nuova scheda), nella sua edizione per la ricerca.